Chaque jour, dans les SOC (Security Operations Center), les alertes s’accumulent. La plupart se révèlent être des faux positifs, et pour repérer les vraies attaques, il faut enquêter sur chaque alerte en croisant les informations de plusieurs outils. Face au volume, ce travail devient intenable : selon le SANS Institute (2025 Detection & Response Survey), 73 % des organisations placent les faux positifs en tête de leurs difficultés de détection. Le SOC ne manque pas d’outils, mais de temps.
Depuis deux ans, les éditeurs promettent d’y remédier avec le « SOC agentique », qui confie ces enquêtes à des agents d’intelligence artificielle. Sur le terrain, l’enthousiasme est plus mesuré : dans le rapport de mai 2026 du SOC-CMM, référentiel de maturité des SOC, les quelque 200 SOC interrogés jugent encore « limitée » la valeur apportée par l’IA.
Qui croire ? D’après notre étude, les agents sont déjà crédibles pour enquêter, beaucoup moins pour trier et répondre seuls : leur fiabilité en production reste à démontrer. Pour un RSSI, tout se joue dans la méthode : confier les clés à l’IA une à une, cas d’usage par cas d’usage, au rythme des preuves de valeur et de performance.
Du playbook à l’agent : ce qui change vraiment
Ce qui distingue un agent
Les SOC automatisent depuis longtemps : l’apprentissage automatique (machine learning) sert à la détection depuis plus de dix ans, les playbooks SOAR (Security Orchestration, Automation and Response) à la réponse. Un playbook est un scénario écrit à l’avance : il enrichit une alerte, bloque une adresse IP… et s’arrête dès que la situation sort du scénario. Plus récents, les assistants ou copilotes IA aident l’analyste à interroger ses outils en langage naturel et à rédiger ses rapports plus vite, mais ne prennent pas l’initiative de l’enquête. L’enquête, l’une des tâches qui mobilisent le plus les analystes expérimentés, reste donc à leur charge. C’est là que se positionnent les agents IA.
Contrairement au playbook et au copilote, un agent conduit l’enquête. Fondé le plus souvent sur un grand modèle de langage (LLM), parfois combiné à des règles déterministes ou à du machine learning, il choisit lui-même, plus ou moins librement, la suite de ses vérifications. Face à une question ouverte (« cette connexion est-elle légitime ? »), il découpe le problème en vérifications, interroge le SIEM (Security Information and Event Management), l’EDR (Endpoint Detection and Response) ou l’annuaire des comptes (Active Directory, par exemple), garde en mémoire ce qu’il a établi et change de piste quand une hypothèse est écartée.
La différence tient en une question : qui décide de la prochaine étape de l’enquête ? Dans un SOC agentique, ce sont en partie les agents. D’où notre définition : un SOC agentique est un SOC dans lequel des agents IA prennent eux-mêmes en charge une partie du tri et des enquêtes, voire de la réponse, sous le contrôle des analystes.
La liberté laissée à l’agent admet plusieurs degrés. Dans l’approche guidée, le parcours de l’enquête est fixé à l’avance ; le LLM analyse les résultats de chaque étape, formule des hypothèses et rédige ses conclusions. On se situe alors à la frontière entre automatisation classique et agentique. Dans l’approche pilotée par le LLM, c’est lui qui choisit l’étape suivante. La première est plus prévisible, la seconde plus flexible.
Dans les deux cas, l’autonomie d’action reste un choix de l’organisation : qu’un agent sache agir ne signifie pas qu’il faille le laisser faire seul. Un SOC agentique n’est pas un SOC sans humains ; c’est un SOC où l’on décide, tâche par tâche, ce que l’on confie aux agents.
Une même alerte, trois façons de la traiter
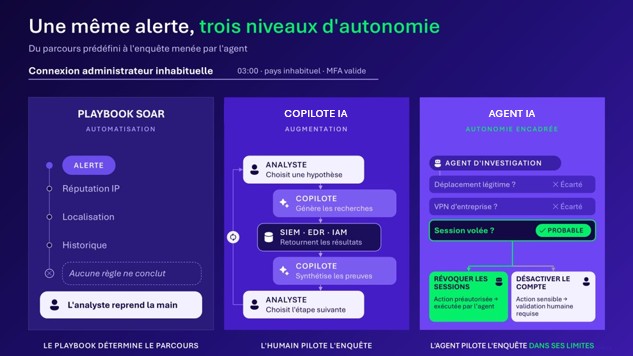
Prenons un cas concret : à 3 h du matin, un compte administrateur se connecte depuis un pays où l’entreprise n’a aucune activité, après une authentification multifacteur (MFA) réussie.
Dans un SOC traditionnel, le playbook ajoute au dossier la réputation de l’adresse IP, sa géolocalisation et l’historique du compte. L’adresse n’étant pas connue comme malveillante, aucune condition du playbook n’est remplie : il ouvre un ticket et s’arrête là. Un analyste devra mener l’enquête à la main.
Avec un copilote IA, l’analyste gagne du temps : le copilote résume l’incident, traduit ses questions en requêtes et rédige le rapport. Mais c’est toujours l’analyste qui décide des questions à poser.
Dans un SOC agentique, ce sont les agents qui mènent l’enquête. L’agent d’investigation envisage plusieurs explications (déplacement, VPN, compromission du compte) et les vérifie une à une. Le poste habituel de l’administrateur est connecté depuis la France au même moment : ce n’est pas un déplacement. L’adresse IP n’appartient à aucun VPN de l’entreprise. Et la MFA ayant été validée, un simple vol de mot de passe ne suffit pas : un attaquant a pu voler une session ou contourner la MFA. La création récente, depuis ce compte, d’une règle de transfert des e-mails vers l’extérieur renforce la piste d’une compromission. Verdict : compromission probable. Les agents révoquent alors les sessions du compte, action qu’ils sont autorisés à mener seuls, et soumettent à la validation de l’analyste la désactivation du compte, trop lourde de conséquences pour être décidée sans lui.
Pourquoi maintenant ?
L’idée d’automatiser l’enquête n’est pas neuve. Trois évolutions la rendent réaliste aujourd’hui :
- La qualité des données: avec les SIEM dans le cloud et des formats communs comme l’OCSF (Open Cybersecurity Schema Framework), les journaux de sécurité s’interrogent de plus en plus facilement par API (interface de programmation applicative), donc directement par un agent.
- La maturité des modèles de langage: ils savent utiliser des outils et enchaîner plusieurs étapes de raisonnement, même s’ils peuvent encore répondre différemment à une même question, inventer des informations ou se laisser manipuler.
- L’essor des protocoles d’interopérabilité: MCP (Model Context Protocol) connecte un agent à ses outils ; A2A (Agent2Agent) vise à faire dialoguer des agents entre eux. De nombreux éditeurs SaaS ont commencé à déployer ces nouveaux protocoles.
Ces protocoles facilitent le branchement des agents sans rendre l’ensemble sûr : la spécification de MCP reconnaît elle-même que le protocole « ne peut pas imposer » ses propres principes de sécurité. Le SOC agentique est donc techniquement possible ; sa sécurité et sa fiabilité, elles, restent à consolider.
À quoi ressemble un SOC agentique cible ?
La vision cible présentée ici s’appuie sur nos échanges avec des responsables de SOC et des éditeurs.
Une couche de plus, pas un SOC de plus
Un SOC agentique ne remplace pas les outils existants : il ajoute, entre les données et les actions, une couche agentique coordonnée par un agent superviseur, aussi appelé orchestrateur. L’analyste la contrôle et peut reprendre la main à tout moment.
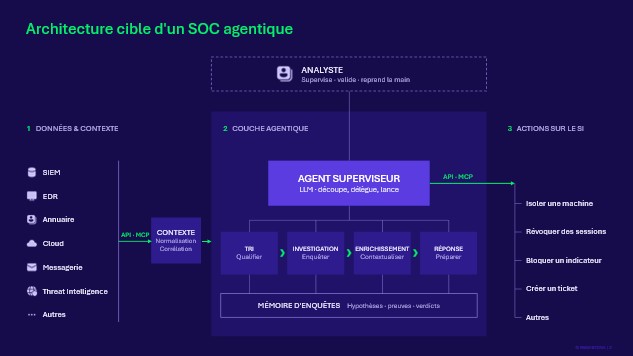
Les outils en place (SIEM, EDR, SOAR…) forment le socle : ils apportent des données déjà normalisées, corrélées et enrichies. Les agents s’y connectent par des API ou des serveurs MCP, d’abord pour récupérer ces données et leur contexte, puis pour agir, directement ou via des playbooks SOAR.
La couche agentique réunit quatre rôles, chacun porté par un agent spécialisé : l’agent de tri qualifie l’alerte ; l’agent d’investigation mène l’enquête jusqu’au verdict ; l’agent d’enrichissement apporte le renseignement sur la menace ; l’agent de réponse prépare les actions à mener sur le système d’information (SI). Ces agents peuvent être distincts ou réunis en un seul ; nous les désignons toujours par leur rôle.
L’agent superviseur coordonne l’ensemble : souvent fondé sur un LLM, il découpe l’alerte en tâches, les confie aux agents spécialisés, suit leur exécution et déclenche les actions préparées par l’agent de réponse, dans la limite de ce qui est autorisé. Il coordonne les agents, mais n’a pas le dernier mot : c’est l’analyste qui garde le contrôle. Dans la suite, « les agents » désigne toute la couche agentique ; quand un point concerne un agent précis, nous le nommons.
Une mémoire d’enquêtes, partagée par tous les agents, conserve hypothèses, preuves et verdicts, confirmés ou corrigés par les analystes, et nourrit les enquêtes suivantes.
Enfin, des contrôles transversaux encadrent l’ensemble : droits minimaux séparant lecture et action, filtrage des entrées, traçabilité de chaque requête et de chaque décision, validation humaine des actions sensibles.
Le filtrage des entrées vise un risque propre aux modèles de langage : l’injection d’instructions. Un attaquant peut glisser des instructions dans un nom d’utilisateur, une URL ou un champ de journal pour détourner le raisonnement d’un agent. Selon une prépublication de mai 2026, non évaluée par les pairs, ces instructions peuvent masquer 68 % des journaux malveillants à un agent d’analyse sans protection. Toute information doit donc être traitée comme potentiellement malveillante.
Le cycle d’une alerte : ce que font les agents, ce que garde l’analyste
Les étapes du traitement d’une alerte ne changent pas : détecter, trier, enquêter, décider, répondre, apprendre. Ce qui change, c’est la répartition du travail entre les agents et l’analyste.
À l’issue de l’enquête, l’agent d’investigation rend un verdict argumenté, assorti d’un score de confiance. Trois cas se présentent : un faux positif est clôturé et documenté ; un cas non concluant remonte à l’analyste avec les pistes explorées ; une menace avérée ou probable passe à l’agent de réponse, qui prépare les actions. L’agent superviseur déclenche seul celles qui sont autorisées à l’avance et soumet les autres à l’analyste.
Le score de confiance peut moduler cette autonomie, à condition d’avoir été calibré sur des cas réels : un score de 90 % ne vaut que si 90 % des verdicts ainsi notés sont justes. Dans tous les cas, l’analyste garde la main sur ce qui engage l’organisation : cas ambigus, actions sensibles, réglage de la détection.
L’essentiel du temps gagné vient souvent de la clôture des faux positifs : dans un essai randomisé mené par Microsoft sur le tri des signalements d’hameçonnage, environ 83 % du gain portait sur les signalements jugés bénins. C’est aussi là que l’erreur coûte le plus cher : une alerte classée bénigne à tort est une attaque qui passe inaperçue. D’où un contrôle des clôtures automatiques par échantillonnage.
L’apprentissage, enfin, reste volontairement modeste : les agents ne réentraînent pas leur modèle, ils enrichissent la mémoire d’enquêtes à partir des corrections des analystes. Chaque apprentissage reste ainsi visible et réversible.
Que deviennent les analystes de niveau 1 ? Leur poste ne disparaît pas, il change : moins de qualification répétitive, davantage de contrôle des clôtures automatiques, de relecture des dossiers d’enquête et de correction des verdicts. Former directement des analystes de niveau 2 serait tentant, mais risqué : c’est en traitant des alertes qu’on apprend à reconnaître une attaque. Le niveau 1 devient un poste d’apprentissage supervisé plutôt qu’un poste de production.
Le marché du SOC agentique : où en est-on ?
Un marché jeune et en mouvement
Le SOC agentique n’est plus un concept de salon : nous avons recensé seize acteurs, répartis en deux familles. D’un côté, les plateformes de sécurité (SIEM, EDR ou XDR, pour Extended Detection and Response) ajoutent des agents à leurs produits, qui disposent déjà des données et des moyens d’action. De l’autre, des éditeurs spécialisés, souvent jeunes, proposent des « analystes SOC IA » qui se branchent sur les outils du client.
Notre méthode : cinq solutions passées au crible
Nous avons étudié en détail cinq solutions représentatives des deux familles, au regard de 26 critères issus d’appels d’offres, d’échanges avec des responsables de SOC et d’ateliers avec les éditeurs. Ces critères sont regroupés en sept axes : détection, tri, investigation, réponse et validation humaine, fiabilité des conclusions, coordination des agents, gouvernance. Chaque critère est noté sur une échelle définie à l’avance, dont les niveaux les plus élevés exigent des résultats mesurés. L’exercice a ses limites : il ne remplace pas un test sur un jeu d’alertes, ne couvre pas tout le marché et reflète l’état des offres à la date de notre étude. Nous présentons donc des tendances plutôt qu’un classement.
Plateforme ou solution indépendante : la première question à trancher
Où les agents sont-ils intégrés ? Le choix du point d’intégration détermine les données qu’ils voient et le chemin que prennent leurs actions. Deux modèles coexistent, qui recoupent largement les deux familles d’acteurs.
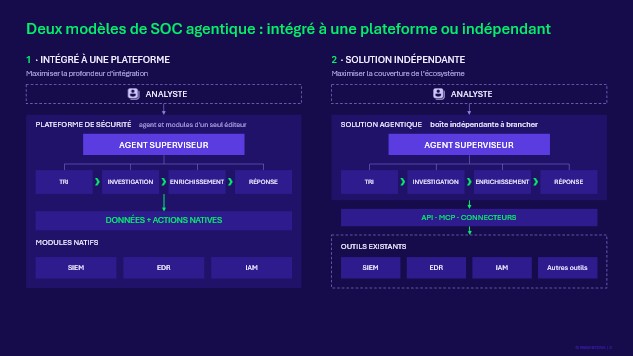
Dans le premier, les agents sont intégrés à une plateforme de sécurité, qui fournit elle-même l’agent superviseur. Ils exploitent les données de ses capteurs, déjà normalisées et corrélées, et agissent par ses fonctions natives. Son atout est l’intégration : un gage de cohérence et de rapidité pour un SOC construit autour de la plateforme, qui profite en outre des nouvelles capacités de l’éditeur au fil de leur sortie. La contrepartie est la dépendance : les agents voient d’abord ce que voit la plateforme, et leur couverture des outils tiers doit être vérifiée.
Dans le second, une solution indépendante, avec son propre agent superviseur et ses agents spécialisés, se branche sur les outils en place. Sans capteurs ni actions natives, et le plus souvent sans base de données propre, elle interroge et actionne les outils du client par API, ou transmet ses recommandations au SOAR ou à l’analyste. Son atout est sa capacité d’adaptation : elle convient aux environnements hétérogènes et aux prestataires multiclients. Mais son efficacité dépend entièrement de la qualité des données et des connecteurs. Et comme le marché se consolide, les grandes plateformes rachetant des acteurs spécialisés, la pérennité de l’éditeur s’évalue autant que sa technologie.
Le choix se résume donc à un arbitrage : d’un côté, l’intégration native et la facilité d’évolution qu’offre l’écosystème d’une plateforme ; de l’autre, la capacité d’adaptation à des contextes hétérogènes. Ces rachats commencent toutefois à brouiller la frontière entre les deux modèles.
Ce qui est mûr, ce qui reste à prouver
Toutes les étapes du cycle d’une alerte n’en sont pas au même point. Notre analyse fait apparaître trois niveaux de maturité :
- Les plus avancés : l’investigation et l’enrichissement. Toutes les solutions de notre échantillon revendiquent les mêmes capacités : construire un plan d’enquête, y compris face à une alerte qu’aucun playbook n’avait prévue, enchaîner les requêtes d’un outil à l’autre, reconstituer la chronologie d’une attaque, apporter le renseignement sur la menace et rendre un verdict argumenté que l’analyste peut corriger. Comme ces étapes ne modifient rien dans le SI, une erreur y reste rattrapable.
- Prometteurs, mais à valider en production : le tri et la réponse. Les capacités existent, mais elles varient fortement d’une offre à l’autre et touchent aux décisions qui engagent l’organisation : clore une alerte, agir sur le SI. Une erreur y coûte plus cher : une alerte close à tort laisse passer une attaque, une action mal ciblée interrompt l’activité.
- Encore émergente : la Le SIEM n’est donc pas mort. D’autant qu’aucun LLM ne pourrait ingérer, à un coût raisonnable, tout ce qu’il voit : les agents s’appuient sur lui pour collecter, corréler et filtrer les données, puis enquêtent sur ce qu’il fait remonter.
L’autonomie, vrai critère de différence
Dès qu’il s’agit de clore une alerte ou d’agir sur le SI, les offres divergent : certaines se limitent à recommander, d’autres agissent directement sur les postes, les identités, le réseau ou le cloud. Sous la même étiquette « SOC IA » cohabitent ainsi de simples assistants, des outils limités au tri et des solutions couvrant tout le cycle. Deux offres dites « autonomes » peuvent donc recouvrir des capacités très différentes.
L’encadrement de cette autonomie varie tout autant. Selon les solutions, tout passe par l’analyste, les agents agissent seuls au-delà d’un seuil de confiance, ou une matrice définit précisément ce que chaque agent a le droit de faire, et sur quelles ressources. Mais une IA ne peut pas évaluer avec certitude sa propre fiabilité : son score de confiance ne vaut que s’il a été calibré à partir de verdicts établis par des analystes. Or aucune solution de notre échantillon ne publie une telle calibration, alors que c’est souvent sur ce score que repose cette autonomie.
Le maillon manquant : l’épreuve du terrain
Sur le papier, les capacités sont là ; reste à les valider en conditions réelles, en particulier pour le tri et la réponse. Aucune mesure de fiabilité n’a été publiée sur un volume réel d’alertes. Trois questions restent ouvertes :
- La reproductibilité: face à une même alerte, l’agent rend-il toujours la même conclusion ? L’ANSSI y voit un « enjeu majeur », mais aucun indicateur ne permet encore d’en juger.
- La comparaison: aucun jeu d’alertes de référence ne permet de comparer les solutions, et la « clôture autonome » ne recouvre pas la même chose d’une offre à l’autre.
- Les gains: ils sont surtout annoncés par les éditeurs, souvent sous la forme d’un « jusqu’à X % », et rarement mesurés en production.
La preuve doit donc venir des deux côtés : les éditeurs doivent publier des résultats comparables, et les clients tester les solutions sur leurs propres alertes. C’est tout l’objet de nos recommandations.
Nos recommandations aux RSSI
Le marché est assez mûr pour se lancer, pas encore pour déléguer sans contrôle. Attendre qu’il se stabilise reviendrait à se priver de l’expérience nécessaire pour, demain, confier davantage aux agents.
Poser les règles d’abord
Poser les règles de gouvernance avant d’accorder la moindre autonomie : donner à chaque agent sa propre identité et des droits minimaux, séparer strictement lecture et action, tracer chaque requête et chaque décision, traiter toute information fournie aux agents comme potentiellement malveillante. Le Top 10 de l’OWASP consacré aux applications agentiques, publié en décembre 2025, offre une bonne grille de départ. Définir ensuite, action par action, ce que les agents peuvent déclencher seuls, selon l’impact de l’action et la facilité à l’annuler, et soumettre tout le reste à validation humaine. Cette délégation s’élargit pas à pas, au rythme des preuves. Ces règles facilitent aussi la conformité à la directive européenne NIS2 et, pour le secteur financier, au règlement DORA.
Démarrer petit, tout mesurer
Ensuite, choisir les cas d’usage où les agents apportent de la valeur sans risque disproportionné, et les ouvrir dans cet ordre :
- l’investigation et l’enrichissement, bons points de départ ;
- le tri ensuite, sous surveillance étroite des faux négatifs, ces attaques classées bénignes à tort ;
- la réponse enfin, en commençant par les actions à faible impact et faciles à annuler.
Pour un premier pilote, l’investigation des signalements d’hameçonnage, des alertes liées aux identités et des alertes EDR est un bon terrain.
Le plus simple est de partir des capacités agentiques déjà intégrées aux outils du SOC. Pour aller plus loin, choisir le modèle d’intégration avant le produit ; développer ses propres agents ne se justifie que pour des sources de données très spécifiques, comme les applications métier.
Face aux éditeurs, exiger des preuves : la fonctionnalité est-elle disponible ou encore en préversion ? A-t-elle été mesurée en production ? Que recouvre précisément la « clôture autonome » annoncée ?
Commencer le pilote en mode observation : les agents proposent, les analystes décident, et l’on compare les verdicts des agents à ceux des analystes. Surtout, le faire déboucher sur un business case (analyse de rentabilité) : sur quels cas d’usage, et à partir de quel volume, les agents créent-ils de la valeur ? Concrètement :
- constituer un jeu d’alertes déjà traitées, dont le verdict est connu, pour comparer les solutions sur ses propres données ;
- définir à l’avance les indicateurs (temps de qualification, taux de remontée à l’analyste, taux de clôture automatique, faux négatifs mesurés par échantillonnage, taux de refus des propositions) et les seuils qui conditionnent l’élargissement de l’autonomie ;
- comparer le coût de traitement d’une alerte par les agents, selon la tarification de l’éditeur (par alerte, par volume ou par licence), à son coût actuel ;
- tester ce que les éditeurs ne démontrent pas encore : reproductibilité des conclusions sur des alertes rejouées, fiabilité du score de confiance, comportement face à des données manquantes, capacité à répondre « non concluant », résistance à l’injection d’instructions dans les données fournies aux agents.
Préparer les équipes
Superviser des agents s’apprend : relire un dossier d’enquête produit par un agent, en repérer les erreurs, résister au biais d’automatisation (la tendance à suivre la recommandation d’une machine sans la vérifier). Pour les nouveaux analystes, cela suppose de rejouer d’anciennes enquêtes, de relire celles des agents et de s’exercer sur des cas simulés. Les parcours de formation sont à repenser en ce sens.
L’offre de SOC agentique s’étoffe vite, et l’investigation menée par des agents tient déjà ses promesses sur le papier. Leur fiabilité en production reste pourtant à démontrer, et leur raisonnement non déterministe impose un cadre que l’automatisation classique n’exigeait pas.
Aujourd’hui, l’investigation est le bon point d’entrée : c’est là que les agents sont les plus mûrs et qu’une erreur reste rattrapable. Ensuite, l’autonomie se gagne, elle ne se décrète pas : elle doit s’étendre au tri puis à la réponse à mesure que les preuves s’accumulent, sur les propres alertes de l’organisation. Enfin, l’analyste ne disparaît pas, il change de métier : moins collecteur d’informations, davantage superviseur de décisions.
À la question « qui décide de la prochaine étape de l’enquête ? », la réponse sera donc graduée : les agents là où leur fiabilité est prouvée et le risque maîtrisé, l’analyste partout ailleurs. Alors, prêts à confier les clés à l’IA ? Pas encore toutes, et pas d’un coup : les confier une à une, au rythme des preuves de valeur et de performance, sera l’affaire des RSSI autant que des éditeurs.