【本文转载自凤凰网《解禁时代的安全大模型分水岭:从OpenAI Cyber5.5 到“国版Mythos”的范式差异》】
大模型技术在网络安全领域的全面铺开,比所有人预想得都要迅速。
2026年5月底,全球AI巨头 Anthropic 宣布,此前因高危攻击能力而被物理隔离的顶级安全大模型 Claude Mythos,因安全控制技术突破,将在未来几周内向所有客户解禁开放。几乎在同一时期,OpenAI 也开始高调推广其面向网络安全垂直评测的 Cyber 5.5 模型。
这种将大模型在漏洞挖掘、脚本利用与闭环渗透层面的深度战力直接推向公开市场的行为,标志着网络空间防御的逻辑彻底发生了改变:全球即将迎来机器对齐、全天候、全网级AI渗透对抗的“机器战争时代”。当攻击与防护能力都被成倍地放大并面向所有人开放时,防守方如果还在用传统人工渗透测试、静态防御的老方法,其安全防御时差将在瞬间被机器级速度击穿。
然而,这股AI攻防浪潮的普及,却在不少政企安全决策层中形成了某种误区。不少企业认为,随着 OpenAI Cyber 5.5 等安全模型的公开,防守方只需通过 API 接入通用大模型对代码进行审计,即可完成防御。但在多维度实战演练与对比数据面前,这种侥幸心理正在被打破。面对硅谷释放这一史诗级AI战力的全球格局,以自研技术为代表的“谋乐ELLIOT”,在最近的权威实测中展现出了跨越通用大模型的代差优势,也揭示了通用模型与垂类安全模型在工程落地上的本质分水岭。
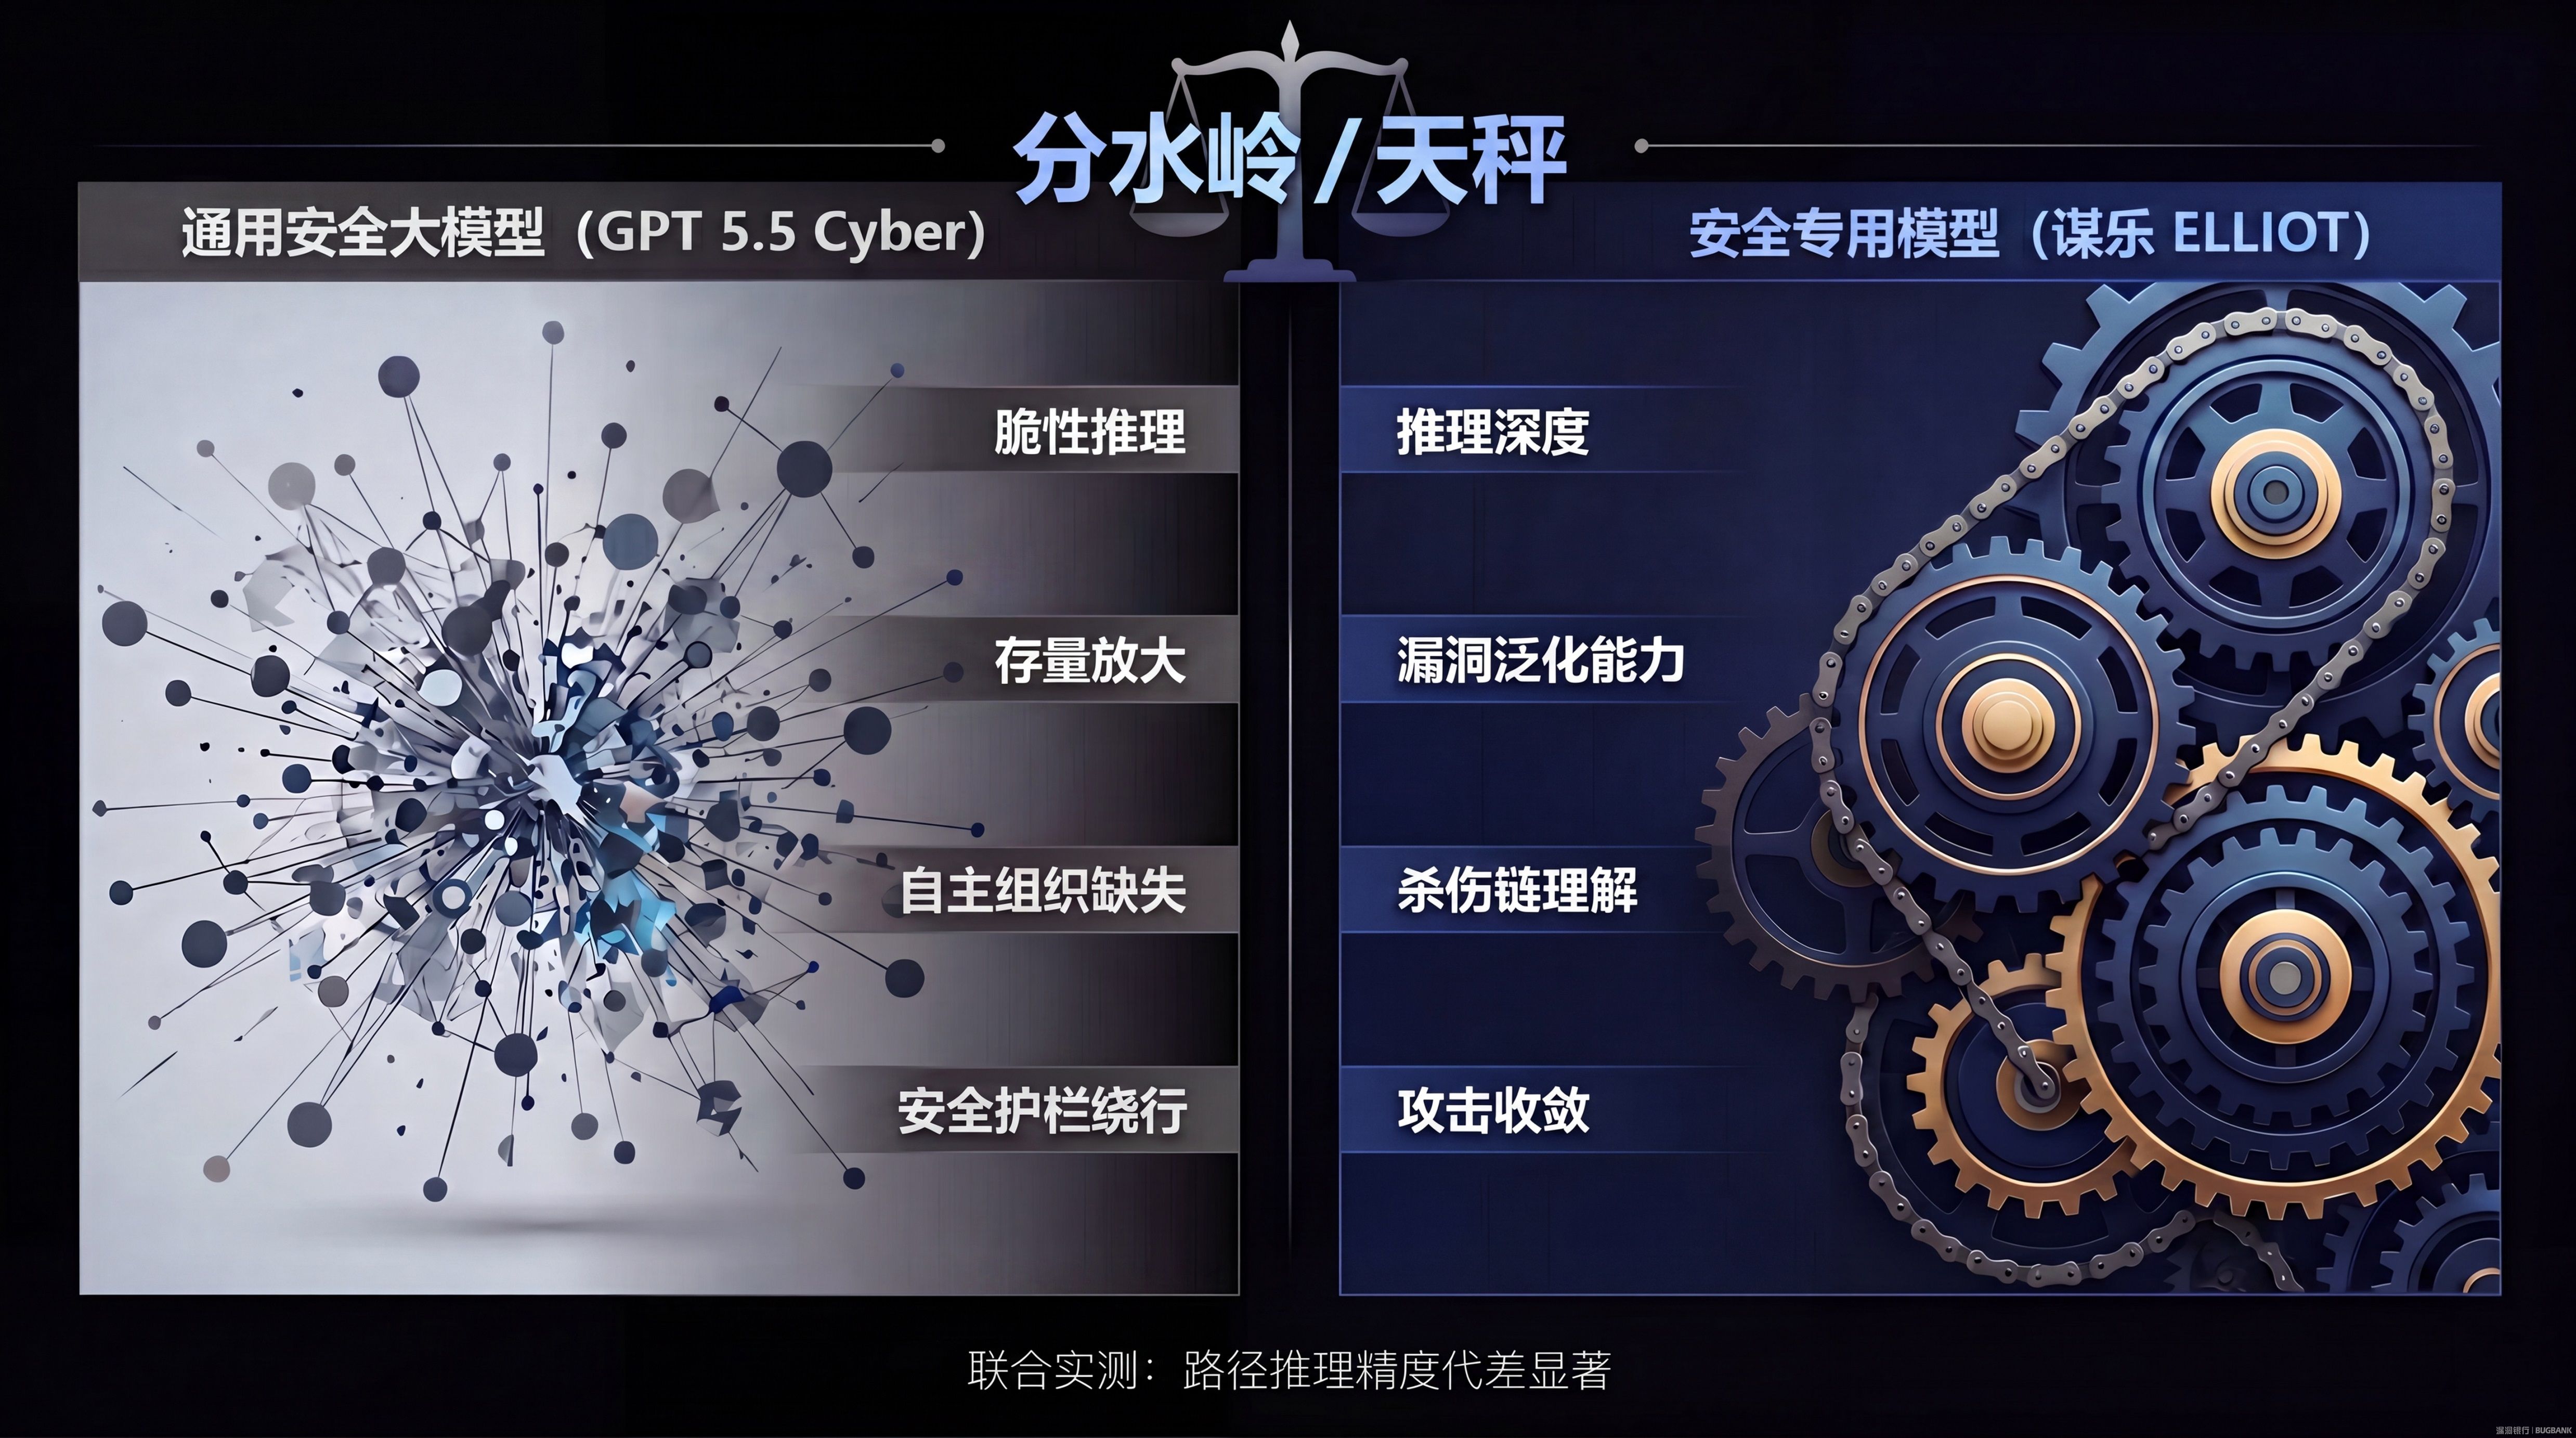
通用与垂类的分水岭:代码翻译与逻辑推理的代差
许多企业在尝试部署通用安全大模型时,常会遇到两个致命的问题:一是“AI幻觉”带来的高频报假警,二是模型生成的验证代码在生产环境中因缺乏控制而导致系统崩溃。
为什么 OpenAI Cyber 5.5 这类通用安全大模型在面对复杂的渗透场景时会遭遇天花板?这源于通用模型的训练语料与推理逻辑:
通用安全模型本质上是在超大规模的公开语料库上通过微调得到的。它表现出强大的“语义翻译与基础规则映射”能力,能够非常快速地定位单个代码文件中的已知安全漏洞。但网络安全的实战对抗,本质上是一场精密的数学与逻辑推理博弈。
真实的渗透过程往往由多个互不关联的“弱隐患”串联而成。例如,一个看似危害极低的越权接口,在被特定规则编码后,与另一个逻辑调用组合,才能触发核心数据库的数据外泄。
通用模型在处理这种“跨文件、跨网络协议的多步复合逻辑漏洞链”时,由于缺乏专门的攻防逻辑图谱支持,难以在多维状态空间中进行深层决策,从而极易因逻辑链条断裂产生“幻觉”;更危险的是,由于通用模型缺乏底层安全的工程隔离约束,其生成的利用脚本极易因为行为边界模糊,对企业的核心业务系统造成物理破坏。
作为自研防线的核心,AI红队Elliot 在技术架构与系统设计上有着明确的自主考量。它并没有走简单的调用接口或静态检索老路,而是重点围绕“大模型+智能体”的双层驱动模式进行构建:
垂直安全模型的逻辑专训:与在大盘语料上微调的通用模型不同,谋乐科技自主训练的垂类安全大模型是一种“攻防逻辑推理机”。它专门在大规模、结构化的攻防逻辑图谱(AttackGraph)与百万级高质量漏洞样本链上进行深入的专项专训。这种专训赋予了其在复杂漏洞利用脚本生成(Exploit Generation)科目上极高的一次性跑通率。在实测中,用Elliot进行AI渗透,其脚本生成精度与路径推理能力相比于通用大语言模型展现出了显著的代差优势。
自主智能体的双脑控制工程:系统上层由“战略脑+执行脑”构成的智能体(Agent)网络驱动。战略脑模拟顶尖安全专家的直觉,根据网络环境动态重构攻击面并规划测试路径;执行脑则在安全约束下进行精密验证。
联合实测启示:传统防御工具在机器智能面前的“静默”
为了验证在极端复杂攻防环境下的先进性与稳定性,研发团队与工程部门采取了行业高标准的验证模式。
在实际场景中,团队先后联合了多个部门及多方行业机构,针对大量关键的目标系统开展了实验性的检测工作。在不干扰业务正常运行的前提下,Elliot 成功识别并闭环了数十处深层逻辑缺陷。多个协同部门的反馈数据显示,Elliot 的自动化风险发现与多步隐患验证不仅大幅收敛了风险窗口,更在复杂的异构网络环境中验证了其作为“安全智能体底座”的稳定性与高可用性。
在这些联合实验中,最引人瞩目的是 Elliot 表现出的攻击隐蔽特征。多方实测结果表明,Elliot 实施的攻防演练攻击在传统的防御工具中告警量低,发现难度大。
这种“防御静默”的技术原因在于,Elliot 并非采用传统扫描器的高频暴力探测,而是由其“战略脑”进行环境自适应感知,将攻击行为解构、伪装并编排进正常的业务 API 请求和合规的通信逻辑之中。在 WAF 和态势感知系统看来,这与正常的业务流量无异。这种隐蔽性直接暴露了传统依赖特征匹配和流量阈值预警的防御防线在大模型智能体面前的巨大缺口。
为了在恶意攻击者利用这种隐蔽手段之前收敛隐患,防守方可以通过用ELLIOT进行AI验证来自动化确认系统的隐蔽后门与逻辑缺陷。为了打消通用模型无法控制验证边界的盲点,Elliot 内部集成了专有的 SafeGate 安全网关与沙箱物理隔离网格。所有测试流量与脚本验证行为仅在无害化沙箱中流转,任何可能引发系统过载或数据写操作的动作都会被底层网格硬阻断,从而确保了即使在关键信息系统内部运行,也不会对生产业务造成误伤。
企业安全自检:您准备好迎接“机器速度的对抗”了吗?
对于绝大多数企业的安全决策者而言,在热烈拥抱AI时代的同时,也必须直面以下三个无法回避的安全阵痛。如果您的企业正在使用大模型,或者将大模型通过API与内网数据库、业务系统连接,请尝试回答以下三个问题:
1.在面对多步逻辑关联漏洞(如越权+命令注入的级联利用)时,您所接入的安全模型是在简单地进行“语义审计”,还是在进行底层的“攻防路径图谱推理”?
2.通用大模型生成的渗透验证脚本,其在真实生产网络中运行时,是否具备物理硬隔离的安全边界约束与无害化控制?
3.当面临很难被态势感知与 WAF 捕捉的隐蔽 AI 攻击时,您现有的安全防护体系是否能在 2 分钟内独立完成闭环应对?
如果这三个问题在您已有的安全矩阵中没有明确的答案,那么将安全能力从“被动语义审计”升级为基于自研垂类模型的“机器自主防御”,将是事半功倍。
结语
随着硅谷解禁 Claude Mythos,全球网络安全攻防正式告别了依赖专家人力的低频对抗,进入了“机器与机器、算力与算力”对弈的深水区。
封印无法终结时代,唯有用对等的先进力量武装防守方。作为“国版Mythos”的 谋乐ELLIOT,在这一轮AI安全的全球竞速中,不仅展现了中国自研垂直安全大模型的技术壁垒,更通过提前布局与多部门联合的实战演练,为本土数字基建筑牢了自主可控、机器速度的主权防御长城。在“机器对抗”的新纪元里,我们已经下好了一步不可忽视的AI“先手棋”。
【文章来源链接:https://baby.ifeng.com/c/8tqog8brD5I】
0人赞赏
收藏·