对于挖矿的检测以及防御方案
 ·2022-04-02 16:19·2 分钟·13K·历史精选
前言 网上对于挖矿的检测也有很多的专业文章,笔者在此就对网上的文章做一个汇总再加上自己的一些不太成熟的想法,欢迎各位师傅们的探讨,当然,检测的方法还是从2个方向出发,基于流量层的检测以及主机行为的检测 基于流量的检测 一.流量特征 对于挖矿,我们最熟悉的协议就是以太坊stratum协议,当然笔者这里就不分析stratum协议了,我们来看看stratum协议的特征,这是常见的stratum协议 {"
前言
网上对于挖矿的检测也有很多的专业文章,笔者在此就对网上的文章做一个汇总再加上自己的一些不太成熟的想法,欢迎各位师傅们的探讨,当然,检测的方法还是从2个方向出发,基于流量层的检测以及主机行为的检测
基于流量的检测
一.流量特征
对于挖矿,我们最熟悉的协议就是以太坊stratum协议,当然笔者这里就不分析stratum协议了,我们来看看stratum协议的特征,这是常见的stratum协议
{"id": 1, "method": "mining.subscribe", "params": ["cpuminer/2.5.0"]}
通常包括关键字mining以及json格式这2点。
XMRig通信协议(jsonrpc)
我们防守方的检测规则,主要基于mining,jsonrpc,aseed_hash,job_id等一些敏感关键字的匹配,然后查看数据包是否为json格式,至于xml门罗币的检测,一般是有登陆包和提交包,我们可以关联一下这2个包,以至于减少误报率,主要匹配login,submit等关键字的匹配。
ps:我们也可以根据比特币钱包地址的前缀检测是否是存在挖矿行为,正如我们的银行卡招商,农业等不同银行的卡号有不同的特征
比特币:大多数为34位,数字字母(大小写)组成,大多数以数字1或3开头
门罗币:有95位数字字母(大小写)组成,大多数以数字4或8开头
乌龟币:有99位数字字母(大小写)组成,TRTL开头
二.威胁情报
配合各个威胁情报部门,收集标记矿场IP,域名通信地址,钱包地址,挖矿木马的HASH,加密流量指纹等信息
基于主机层的检测
挖矿主要有基于被动和主动,主动好理解,就是被入侵了,被动是什么呢?就是浏览器挖矿
一.前端浏览器挖矿(被动)
首先什么是浏览器挖矿,怎么理解,普通的挖矿木马则是基于消耗服务器cpu内存,而浏览器挖矿则是消耗浏览器内存进行挖矿,前者在于自己的设备上进行运算,后者在于其他用户访问了该页面,该页面存在xxx.js,就开始挖矿了,常见的为Coinhive脚本以及其他脚本
我们防守方的检测规则,主要基于常见浏览器挖矿脚本的名字正则匹配,md5,hash匹配,以及浏览器恶意占用内存以及持续性的某地址请求,恶意域名提前侦测。
二.攻击链路检测(被入侵或者员工自己挖矿)
打点(web漏洞,钓鱼) -> 挖矿木马自启动/隐藏/权限维持 -> 挖矿木马横向寻找更多矿机
上面是一个比较经典的链路,我们可以对这三点都进行一个检测,如何打点不在本片文件做具体介绍
自启动(开机自启动rc.local,计划任务crontabs,恶意系统服务checkconfig,mac检测这2个目录(LaunchAgents,LaunchDaemons))/隐藏(修改文件名,修改进程名(prctl),隐藏文件),木马横向移动(扫描端口,密码爆破,然后执行自启动这一块),主要用ids流量设备去检查,检测,那么这些技术对应到ATT&CK矩阵图对应了哪些,我们如何通过纵深防御?首先看看对应的TID
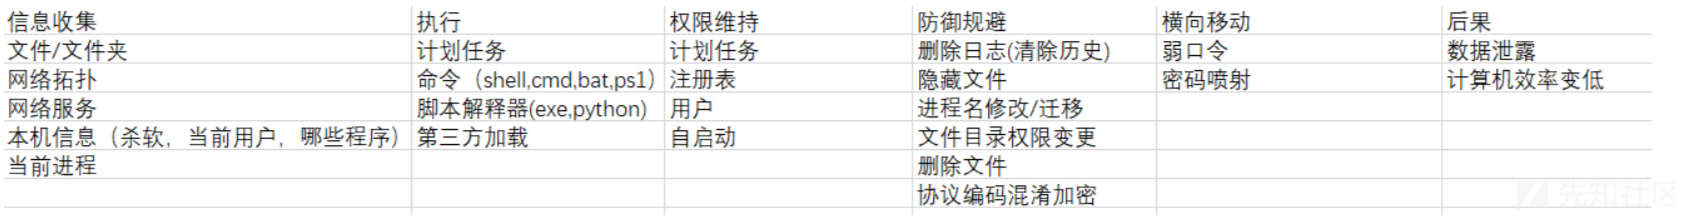
我们一点一点说,首先是我们的信息收集,该类规则必须cep关联规则,不然会产生很大的误报,怎么理解,比如公司员工正常查看进程列表,tasklist /svc,我们不能报错吧,我们的cep关联他之前的操作,比如之前疯狂查找文件夹,看了当前用户,那么该员工可能存在被挖矿的风险,技术难点在于规则的关联且规则准确率很低,目的在于防患于未然。
执行这一阶段,我们也得特别注意,首先是通用的计划任务,taskschd(windows),linux/mac(crontabs)是我们值得重点关注的,其他js的脚本也得看看该Js脚本是否是恶意的,至于linux的机器,因为某些服务器是自带python环境的,我们的特别注意执行的python文件,当然,第三方加载,可能它是一个loader.exe,远程加载挖矿木马。
技术难点:1.利用第三方/白名单去加载,很多情况是攻击者拿到了权限,很少会直接运行挖矿木马,他们可能会丢一个loader去加载木马,亦或者是用windos的一些白名单利用去加载我们的挖矿木马,我们如何防御,首先是loader,我们可以域名白名单,就是不是我们企业的域名或者是办公域名我们隔离掉,无法访问,至于白名单加载,我们也可以终端白名单,我们的规则只允许这些dll或者这些exe运行,当然,如果域名白名单很难落实下来,就重点关注外部的请求。
权限维持阶段,自启动(sc),(rc.local,LaunchAgents,LaunchDaemons等目录),计划任务,注册表(reg,需要提权,相对比较敏感),影子用户(net user)。
防御规避阶段:删除日志(history,del,sfc,rd,wevtutil cl,eventvwr,dumpel.exe,@reg delete Terminal Server Client\Default" /va /f(rdp日志),),隐藏文件(attrib),修改进程名(prctl),文件目录权限变更(chmod),协议混淆编码(加了密的看是谁发起的,可信任的能放行外一律拦住)
windows日志位置(windows也可能没有罗列完):
系统日志:%SystemRoot%\System32\Winevt\Logs\System.evtx
安全日志:%SystemRoot%\System32\Winevt\Logs\Security.evtx
应用程序日志:%SystemRoot%\System32\Winevt\Logs\Application.evtx
日志在注册表的键:HKEY_LOCAL_MACHINE\system\CurrentControlSet\Services\Eventlog
IIS默认日志位置:%SystemDrive%\inetpub\logs\LogFiles\W3SVC1\
横向移动阶段:挖矿木马以及人为操作横向移动,基本都是基于简单的弱口令,以及简单的端口爆破,21,22,445,3389等端口,我们需要做的就是如果非业务需求,关闭不常用的端口,还有就是密码策略的要求,以及登录限制。
简单总结:对于攻击链路的检测,我们还是的把重心放在执行,权限维持,防御规避,横向移动这四个阶段,因为这四个阶段相对特征比较敏感明显,至于信息收集这一端的,我们关联相关策略,当然,说到这里,笔者也有一些不成熟的意见,要想让防守做到滴水不漏,至少在目前看来是不可能的,要想提升防御质量的关键在于我们能否掌握主动权,那我们防守方的主动权在于哪里,在于攻击者对我们环境的未知,对我们架构,防线的未知,比如同样是一个命令ipconfig,但是不同的命令变形也可以做到同样的效果,那么执行前者是危险,执行后者是安全的,当然这只是一个思路,具体怎么让这个思路更加活跃起来,看读者们自己的发挥

排查清理
我们通常可以用top查看使用cpu较高的命令(windows就用wmic cpu get loadpercentage或者看任务管理器),netstat -ano查看是否有外联的ip地址,ip可用微步查看,history历史执行的命令(windows看日志),ps -ef查看进程(windows就是tasklist /svc),接下来就是查找后门文件,windows主要关注注册表,隐藏用户,web服务的后门,计划任务,自启动等常见后门,linux主要关注计划任务,ssh是否被劫持,开机自启动等。至于朔源的话,我们的找到矿池IP或者是钱包地址,以及攻击者打点进来用的什么手法,工具,看能否分析出有关其信息。
写在最后
随着攻防对抗的升级,越来越多的技术需要学习,云上的攻防对抗,算法的学习,文笔粗糙,如有错误,望看官斧正